Ele ajudou a construir o ChatGPT. Por que sua nova IA não conversa?
Do InstructGPT às decisões rápidas: o que muda com o Jev, seu papel no software e por que uma saída válida não garante uma decisão correta.
Por Prompthon9 min de leitura
Traduzido de 简体中文
AI
Industry Signals
Jev
Ilustração editorial gerada por IA.Crédito da imagem: Prompthon. GPT-localized editorial illustration; not factual photographic evidence.
Em 15 de setembro de 2026, Diogo Almeida apresentou um produto que não escreve artigos nem mantém uma conversa. É uma mudança curiosa para alguém cujo trabalho na OpenAI ajudou modelos de linguagem a seguir instruções humanas.
O produto se chama Jev. Ele recebe a descrição de uma situação e uma pergunta específica, e devolve uma opção, uma nota ou uma probabilidade que o software pode usar para dar continuidade a um processo.[1]
Seria fácil contar essa história como a de um criador do ChatGPT abandonando suas ideias anteriores. A trajetória sugere uma pergunta mais interessante. Primeiro, foi necessário ensinar os modelos a entender o que as pessoas queriam. Agora, os desenvolvedores precisam decidir o que o software deve fazer com a resposta.
Para entender o Jev, vale acompanhar essa passagem de responder perguntas a participar da execução. Ela também ajuda a separar decisões que podem caber a um modelo rápido daquelas que ainda exigem raciocínio mais profundo ou revisão humana.
2022: continuar um texto não era o mesmo que cumprir uma tarefa
Em 27 de janeiro de 2022, a OpenAI apresentou o InstructGPT. Modelos de linguagem sabiam dar continuidade a um texto, mas isso não significava que executavam bem o pedido do usuário.[2]
Imagine uma loja virtual recebendo uma reclamação. Você pede ao modelo um resumo do problema. Ele, porém, trata a mensagem como o começo de uma história e continua escrevendo. O texto é fluente; a tarefa continua sem solução.
O InstructGPT usou demonstrações humanas de boas respostas e comparações entre respostas alternativas para orientar o treinamento. Essa abordagem é chamada de aprendizado por reforço com feedback humano, ou RLHF. Em termos simples, o modelo aprendia com exemplos e avaliações do que as pessoas consideravam uma resposta melhor.
Almeida foi um dos coautores do artigo disponibilizado em 4 de março daquele ano. O trabalho não apresentou o método como uma solução definitiva: os modelos seguiam melhor a intenção do usuário, mas ainda cometiam erros simples.[3]
Esse contexto importa. Reduzir a pesquisa a ensinar a IA a agradar pessoas deixa de lado o problema que ela resolveu. Dar uma tarefa ao modelo e esperar que ele siga as instruções já era um avanço importante.
Mas a integração com o atendimento ao cliente expôs a etapa seguinte. Explicar que um cliente talvez precise de reembolso não informa automaticamente ao programa para onde encaminhar o chamado, qual pedido consultar ou quando exigir aprovação.
2023–2024: os modelos já estavam se conectando ao software
A OpenAI lançou a chamada de funções em 13 de junho de 2023. O desenvolvedor podia descrever as ferramentas disponíveis e seus parâmetros; o modelo devolvia informações de chamada que um programa conseguia interpretar.[4]
No exemplo da loja, uma pergunta sobre entrega poderia levar o modelo a sugerir uma consulta de rastreamento e informar os dados do pedido. A consulta em si continuaria sendo executada pelo software.
Em 6 de agosto de 2024, o recurso Structured Outputs passou a restringir ainda mais as respostas a um formato definido pelo desenvolvedor.[5] Um classificador de chamados poderia ser obrigado a escolher entre entrega, reembolso e dúvida sobre produto. A própria OpenAI observou o limite: uma resposta no formato correto ainda pode conter um erro.
Portanto, o Jev não inventou a ideia de conectar a saída da IA ao software. Os modelos de uso geral já vinham melhorando nessa direção.
O Jev faz uma pergunta mais específica: se uma etapa só precisa de uma escolha, nota ou avaliação, ainda é necessário gerar uma resposta token por token?
São desafios relacionados, mas diferentes. A saída estruturada controla o formato da resposta. Um modelo pensado para decisões rápidas também tenta reduzir o tempo e o custo de produzi-la. Os avanços anteriores podem ser reais, e ainda assim deixar espaço para novas abordagens.
2026: outro tipo de resposta
No texto de lançamento, Almeida relembrou dois anos longe dos holofotes, durante os quais a TypeSafe desenvolveu arquitetura de modelos, métodos de amostragem e treinamento voltados à automação. Sua pergunta era por que tantas tarefas ainda resistiam à automação confiável, apesar do progresso das IAs de conversa. Essa é sua tese como empreendedor, não um consenso estabelecido no setor.[1]
A equipe chama esses modelos de System One, tomando emprestada a expressão do livro Rápido e Devagar.[1] Aqui, ela ajuda a descrever decisões rápidas sobre perguntas delimitadas, com informação suficiente. O nome não significa que o modelo possua intuição humana, nem que rapidez garanta acerto.
A documentação apresenta três operações básicas: escolher entre opções fornecidas, atribuir uma nota segundo um critério e estimar a probabilidade de uma afirmação ser verdadeira. Várias perguntas podem ser processadas em paralelo na mesma solicitação.[6]
Para uma reclamação por e-mail, seria possível perguntar: Qual equipe deve atendê-la? Qual é a urgência? Falta o número do pedido?
O software pode encaminhar os resultados por regras previamente definidas. Um modelo de uso geral redige a explicação ao cliente; código e ferramentas consultam pedidos e conferem valores. O desenvolvedor continua responsável pelo processo completo. O Jev cuida de uma avaliação específica dentro dele.
Essa especialização tem um preço. Custo menor não transforma o modelo em substituto para escrita livre, explicações longas ou raciocínio complexo.
O que a atenção inicial realmente mostra?
Três datas ajudam a dimensionar o lançamento:
15 de setembro: a TypeSafe apresentou o Jev e abriu o acesso antecipado.[1]
16 de setembro: a Vercel anunciou sua disponibilidade no AI Gateway.[7]
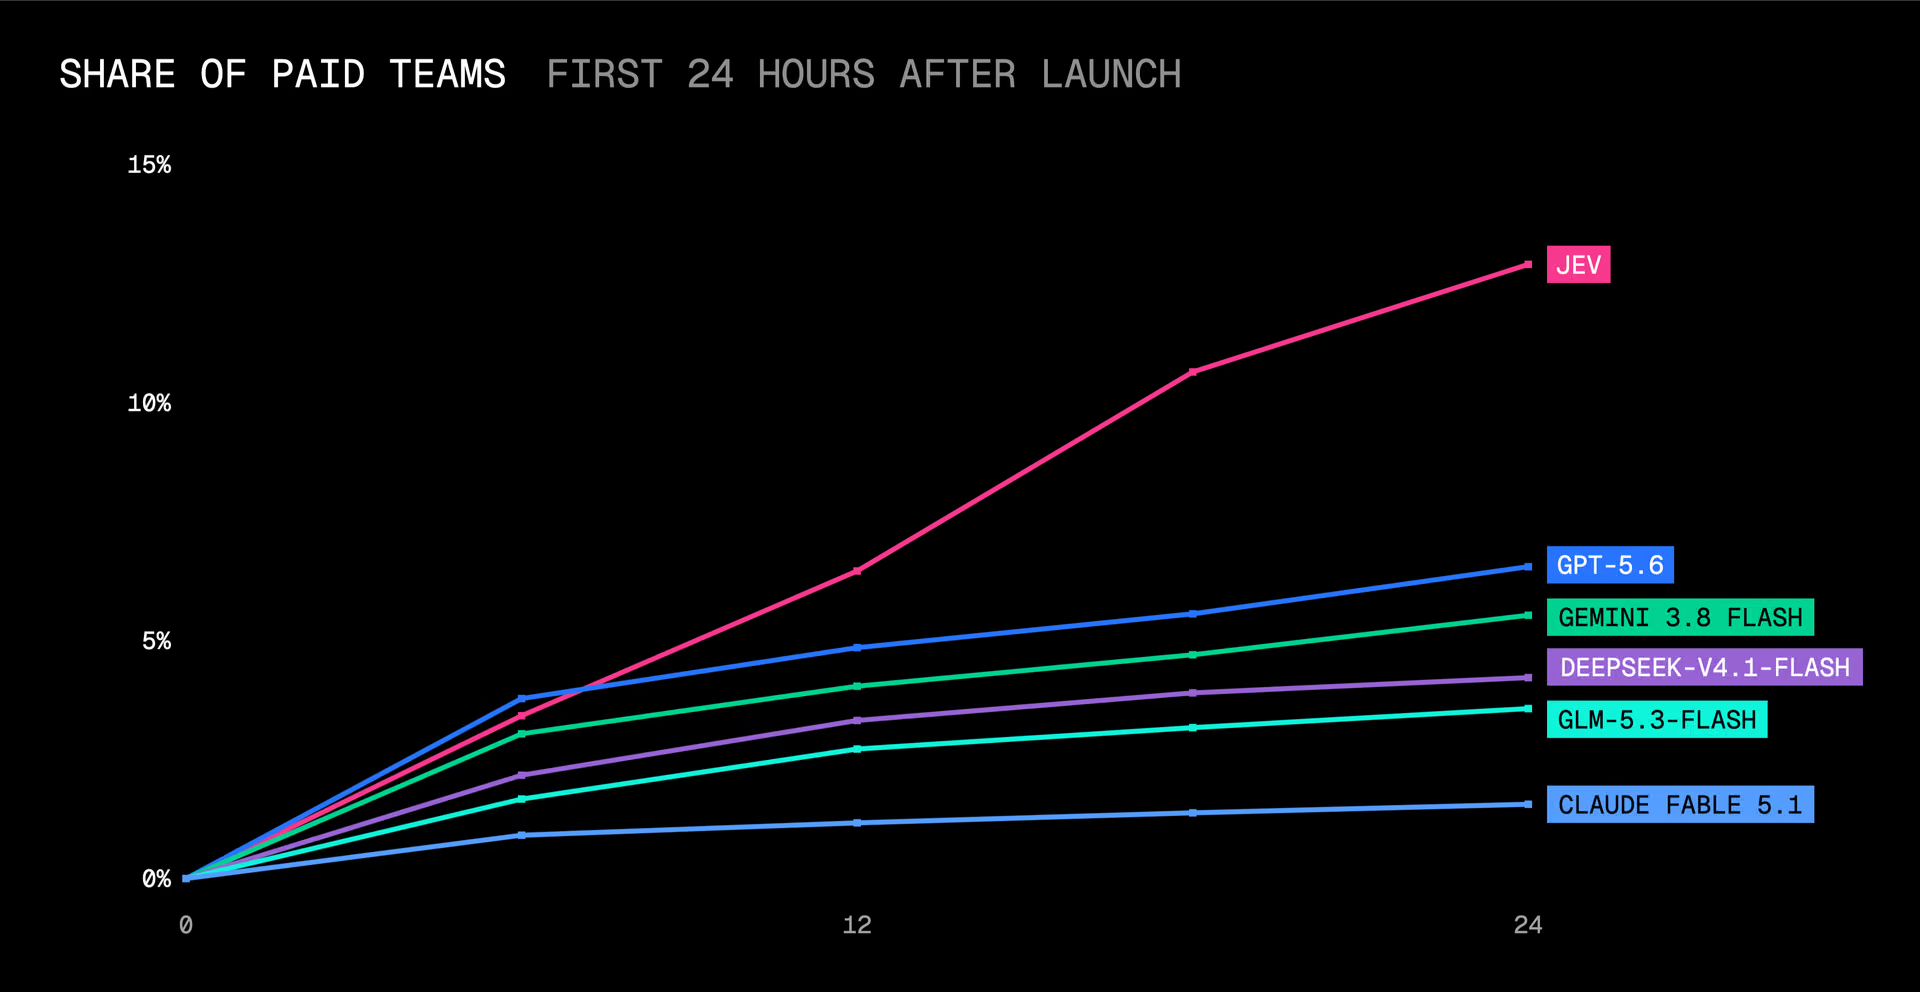
18 de setembro: a Vercel informou que quase 13% de suas equipes pagantes haviam utilizado o Jev nas primeiras 24 horas de disponibilidade na plataforma.[8]
Crédito da imagem: Vercel, 2026-09-18. Official AI Gateway first-day adoption chart; unchanged apart from AVIF to PNG conversion.
Fonte: Vercel, 18 de setembro de 2026. O gráfico oficial foi mantido em inglês, sem redesenho. O eixo horizontal mostra as horas desde o lançamento; o vertical, a adoção entre equipes pagantes da plataforma. Não representa a proporção global de desenvolvedores nem a taxa de sucesso nas tarefas.
É um sinal relevante da disposição dos desenvolvedores para experimentar. Ainda não mostra por quanto tempo continuarão usando o produto ou quais tarefas terão resultados melhores.
A TypeSafe informa preço de entrada de US$ 0,042 por milhão de tokens, sem cobrança separada pela saída.[11] Tokens são unidades de processamento de texto, não uma contagem direta de palavras. A empresa divulga tempos de resposta de ponta a ponta entre 70 e 500 milissegundos; cada solicitação pode variar.[1]
As alegações de desempenho cerca de 194 vezes mais rápido e custo 445 vezes menor vêm de uma avaliação de fluxo de trabalho feita pela própria TypeSafe. A empresa reconhece que os ganhos podem estar próximos da faixa superior do que se obtém na prática. A comparação também usou previsões médias de outros modelos fortes como referência, em vez de conferir todas as tarefas com resultados reais de negócios.[1]
Para quem pretende adotar a ferramenta, a pergunta mais útil é o que acontece com a precisão, o volume de revisão humana e o tempo total de espera no próprio processo. Uma chamada barata que produz mais retrabalho pode não reduzir o custo da tarefa.
“Zero alucinações” não significa “nunca escolhe errado”
Voltemos à loja. Se as saídas permitidas forem entrega, reembolso e dúvida sobre produto, o Jev não inventará um quarto departamento. Isso elimina uma categoria bastante incômoda de erros de integração.
Mas ele ainda pode escolher reembolso quando o cliente pergunta sobre entrega. A resposta é válida; a decisão está errada.
A documentação de limitações da TypeSafe é clara sobre o Jev 1.13: cálculos numéricos, comparações de datas e raciocínio em várias etapas podem ser difíceis. Informação irrelevante em excesso pode prejudicar a precisão, e entradas enganosas podem afetar a resposta.[9]
A formulação da pergunta, a abrangência das opções e a maneira de lidar com falhas continuam sendo partes essenciais do sistema.
O Jev também oferece probabilidades e confiança para ajudar a tratar a incerteza. A confiança pode ser entendida como a concentração da resposta: se várias opções estão próximas, talvez seja preciso agir com mais cautela. Ela não garante a precisão em qualquer contexto de negócio. Os limites devem ser validados com os próprios dados.[10]
Arquivar um e-mail na pasta errada é reversível. Aprovar um reembolso envolve valores, permissões e verificações. Essas ações não deveriam receber a mesma autorização só porque o modelo informou o mesmo nível de confiança.
Automação confiável exige tanto um modelo capaz de avaliar quanto um software que saiba quando não agir com base nessa avaliação.
De seguir instruções a encontrar o papel certo
Nessa linha do tempo, a nova escolha de Almeida fica menos surpreendente. Em 2022, o desafio era seguir melhor a intenção humana. Depois, a chamada de funções e as saídas estruturadas facilitaram a conexão das respostas com programas. O Jev concentra o foco em pequenas decisões frequentes, com um conjunto definido de respostas.
Na minha avaliação, o teste mais interessante é saber se essa divisão de trabalho funciona em operações reais: modelos de uso geral onde há escrita ou raciocínio mais profundo, modelos especializados para avaliações rápidas e código para aquilo que pode ser calculado de forma determinística.
Se funcionar, o usuário talvez nunca veja um chatbot mais eloquente. Pode apenas perceber que a reclamação chegou rapidamente à pessoa certa, o pedido já foi consultado, os casos incertos foram encaminhados a alguém e não foi necessário explicar o mesmo problema a três atendentes.
Para a IA dentro do software, isso já seria uma melhoria valiosa.
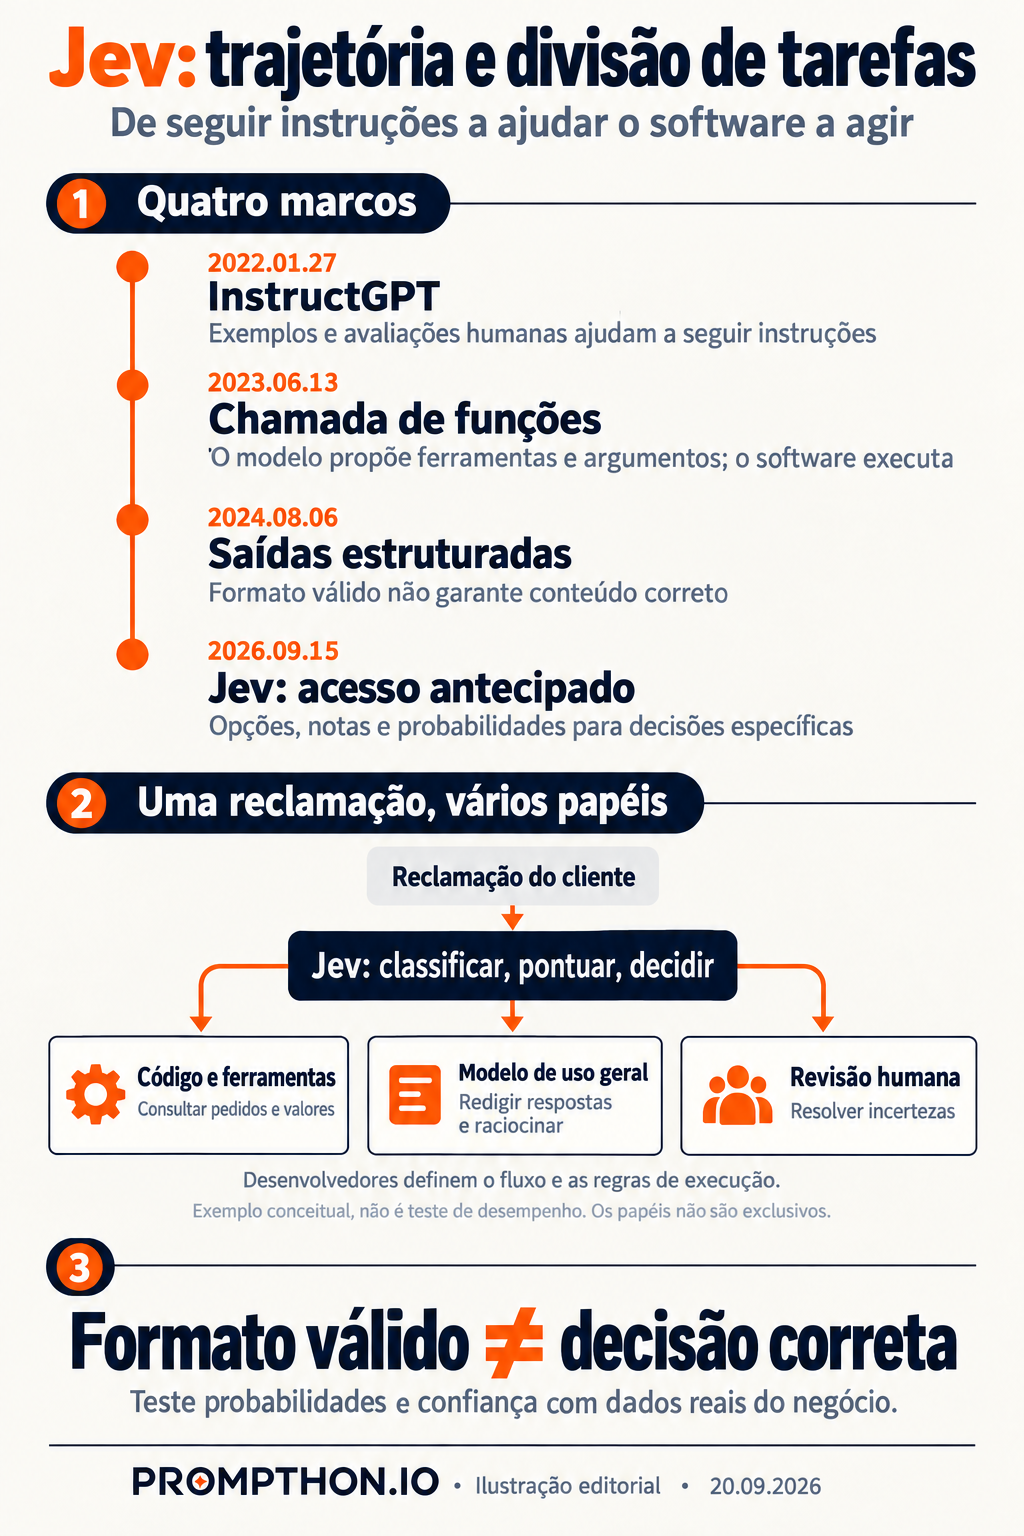
O Jev em uma imagem
Crédito da imagem: Prompthon. GPT-localized editorial illustration; not factual photographic evidence.
Ilustração editorial da Prompthon gerada com GPT, baseada nas fontes abaixo. As datas se referem aos anúncios correspondentes; o atendimento é um exemplo conceitual.
Fontes
Texto baseado em informações públicas disponíveis até 20 de setembro de 2026. Os números de desempenho foram divulgados pelo fornecedor ou pela plataforma; a Prompthon não realizou testes independentes do Jev.