O boletim do GPT-6 Astra, parte 2: O que 99,9% revela sobre AGI?
Dois exemplos públicos do ARC-AGI-3 explicam a nota de 99,9%, a referência humana e a importância do programa de avaliação.
Por Liqing Pan7 min de leitura
Traduzido de 简体中文
AI
Industry
Benchmarks
Crédito da imagem: Prompthon editorial artwork.
Depois de sete avaliações, chegamos à nota que provocou a maior pergunta: 99,9%.
A OpenAI lançou o GPT-6 Astra em 3 de setembro de 2026. Greg Brockman deu as boas-vindas à era da AGI, segundo a Fast Company.[1][2] A primeira parte examinou ciência, matemática, programação e trabalho profissional. Agora vamos ao ARC-AGI-3: o sistema consegue aprender a agir em um ambiente novo sem receber um manual?
AGI significa inteligência artificial geral. A questão é se a competência alcança a aprendizagem em tarefas desconhecidas, além do bom desempenho nas familiares. Uma avaliação oferece evidências; seu nome não resolve a questão.
Veja as tarefas antes de interpretar a nota. Dois exemplos públicos tornam a prova concreta. Depois examinamos a referência humana, o programa que acompanha o modelo e os limites do resultado.
Crédito da imagem: Prompthon editorial artwork.
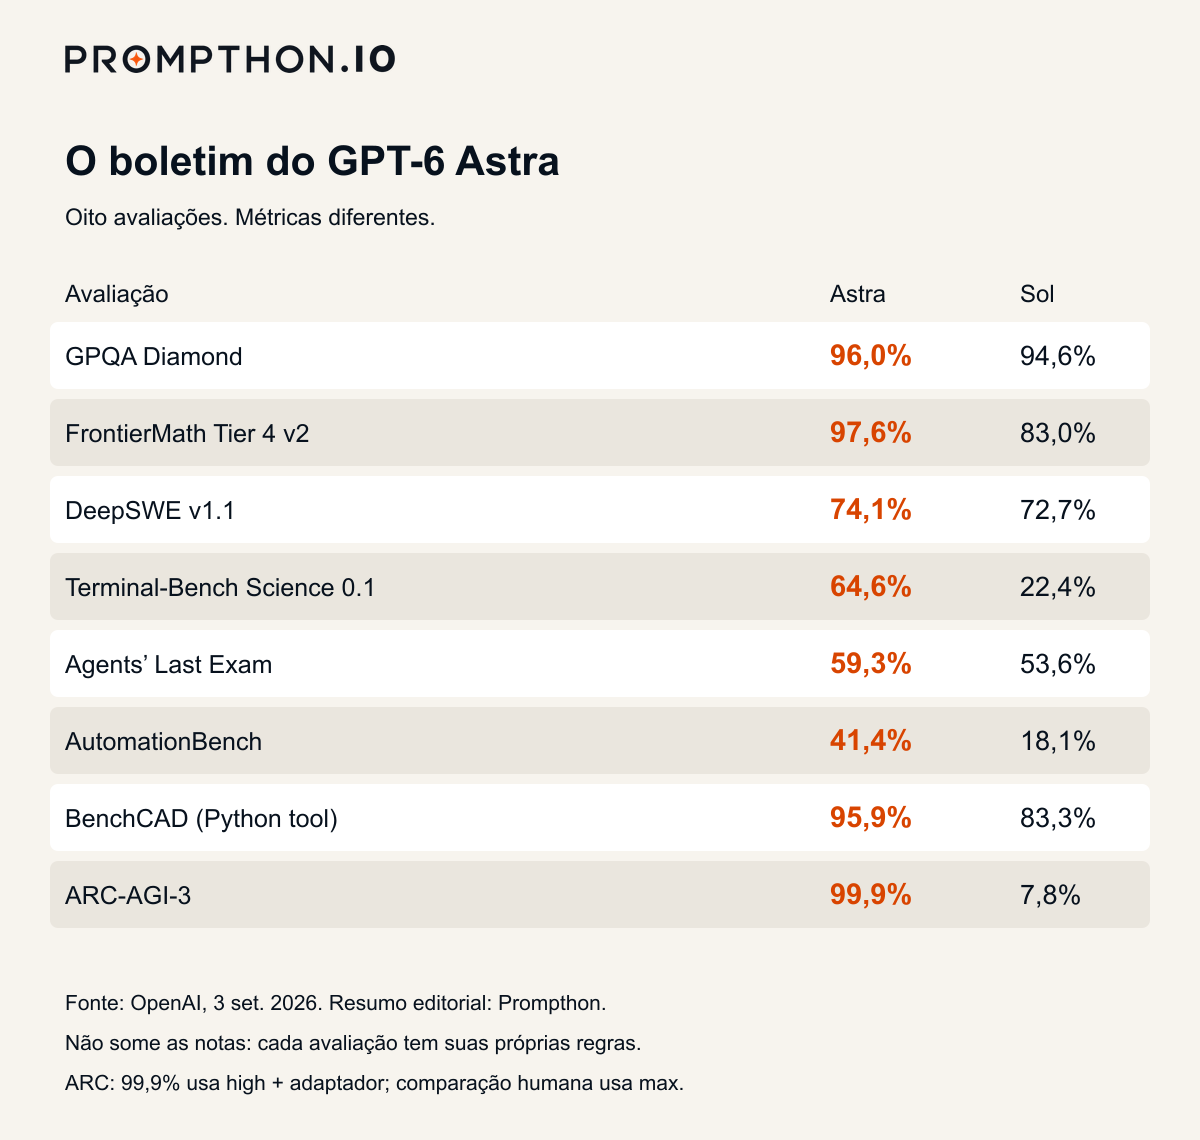
Resumo editorial da Prompthon. Porcentagens usam métricas diferentes e não podem ser somadas. As referências humanas vêm de estudos distintos; a nota do ARC e a comparação humana usam configurações diferentes.
Um pesquisador de aprendizagem profunda faz outra pergunta
François Chollet apresentou o primeiro ARC em 2019. Criador do Keras, ferramenta usada para construir redes neurais, ele perguntava: ser excelente em tarefas conhecidas é o mesmo que aprender novas habilidades com eficiência?[3]
A prova inicial usava grades coloridas. Exemplos de antes e depois indicavam uma regra que precisava ser aplicada a uma nova imagem. O formato não exigia doutorado; decorar uma enciclopédia tampouco entregava a transformação.
A competição de 2020 atraiu 913 equipes; a vencedora resolveu cerca de 20% do conjunto privado. O o3-preview da OpenAI renovou a atenção no fim de 2024.[3][4] A terceira geração permite interagir: agir, observar, rever a hipótese e usar a descoberta em fases posteriores.[5]
Pense em um aparelho desconhecido sem manual. Descobrir como ligá-lo é uma coisa; entender controles que interagem e concluir a tarefa exige tentativas. O ARC-AGI-3 mede esse processo em jogos projetados.
Primeiro exemplo: Os controles aparecem; as regras, não
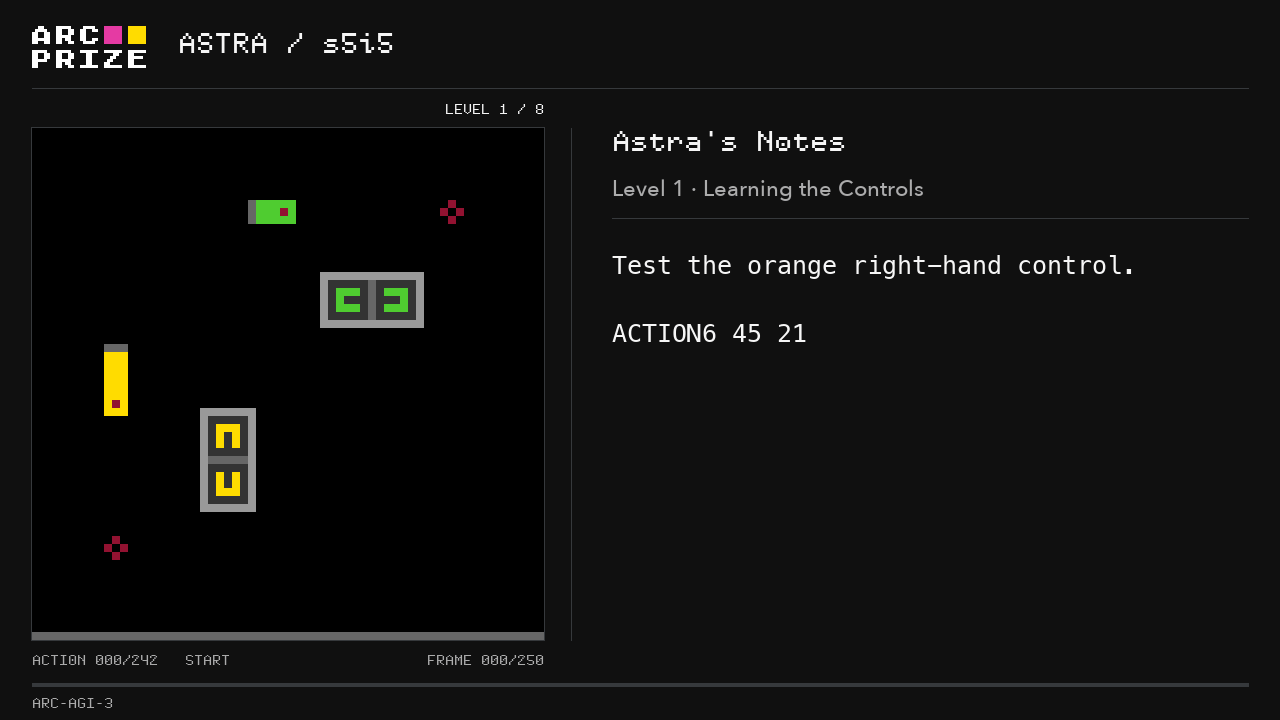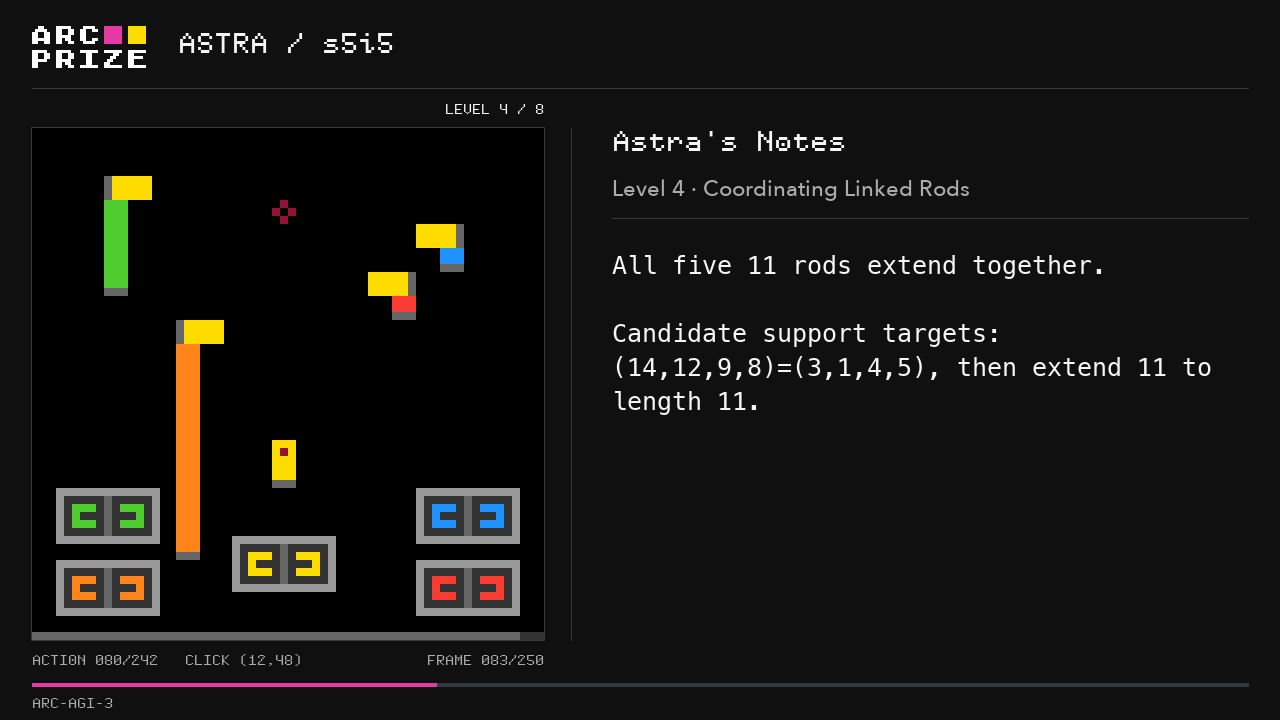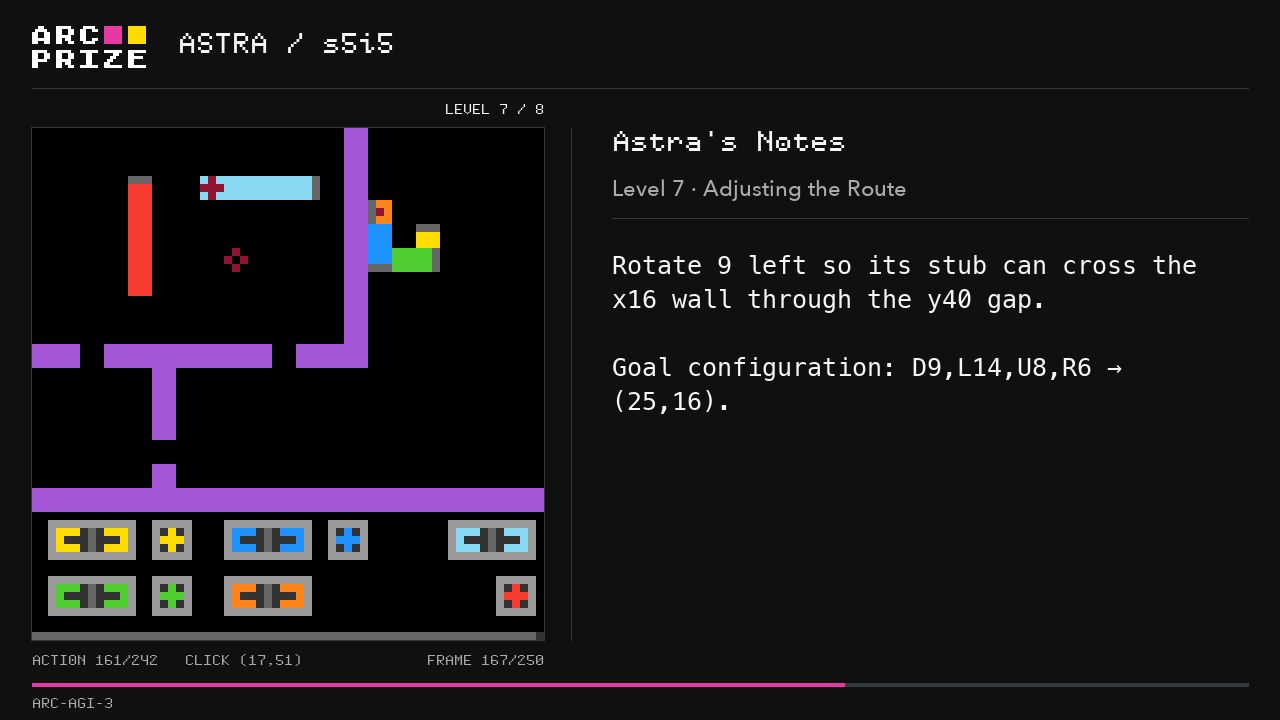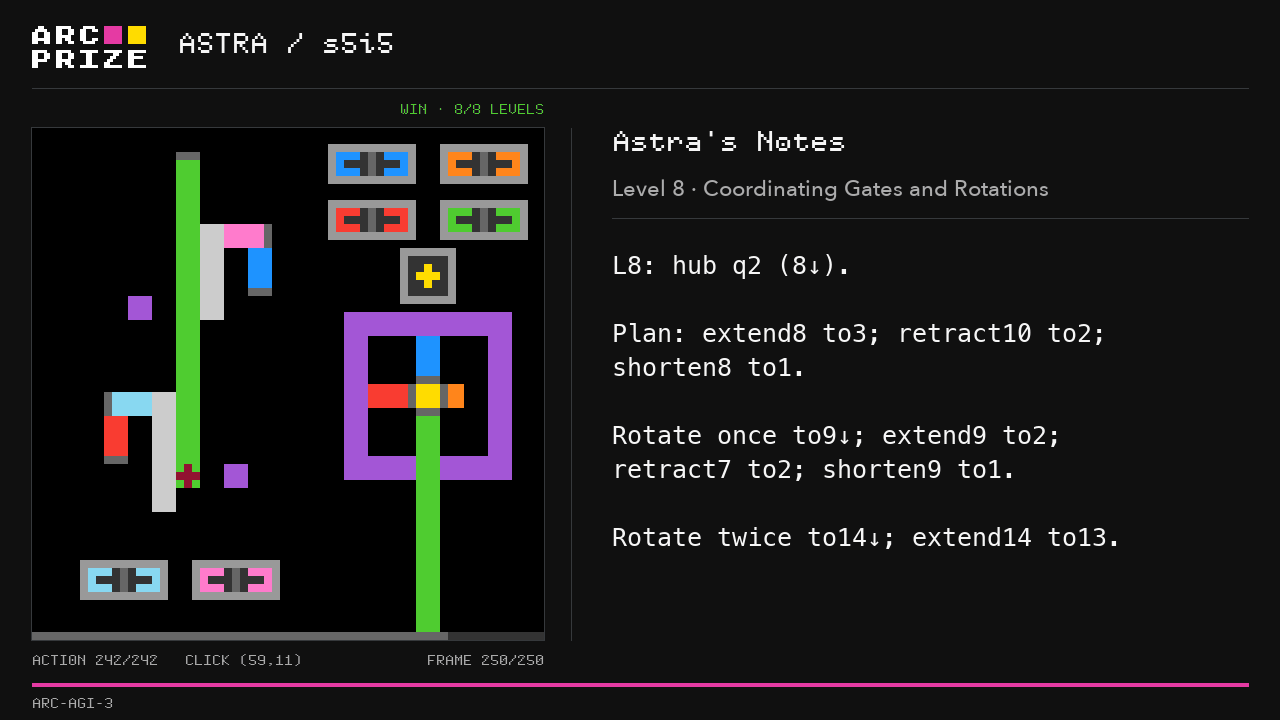
O ambiente público s5i5 contém mecanismos coloridos e controles que alteram seus estados.[6][7]
Exemplo público: s5i5. Qual controle estende uma peça? Qual a gira? Em que ordem mover? É preciso inferir essas relações observando os efeitos e planejar uma sequência.
Crédito da imagem: ARC Prize — Astra evaluation report; official demonstration or comparison.
Animação publicada pelo ARC Prize. Ilustra uma execução pública, não um teste da Prompthon nem uma demonstração de conclusão de todas as fases.
Ao apertar um botão pela primeira vez, talvez você nem perceba o que mudou. Entender um controle não resolve tudo: uma peça estendida pode bloquear outra, e uma rotação muda posições já memorizadas. O modelo precisa conectar as tentativas.
O ARC Prize descreve registros compactos do Astra sobre cores, comprimentos, posições dos controles e operações planejadas.[6] Lembra as anotações de alguém resolvendo um quebra-cabeça mecânico. O ponto interessante é usar a regra recém-descoberta para organizar as próximas ações.
Segundo exemplo: Há caminho, mas os guardas se movem
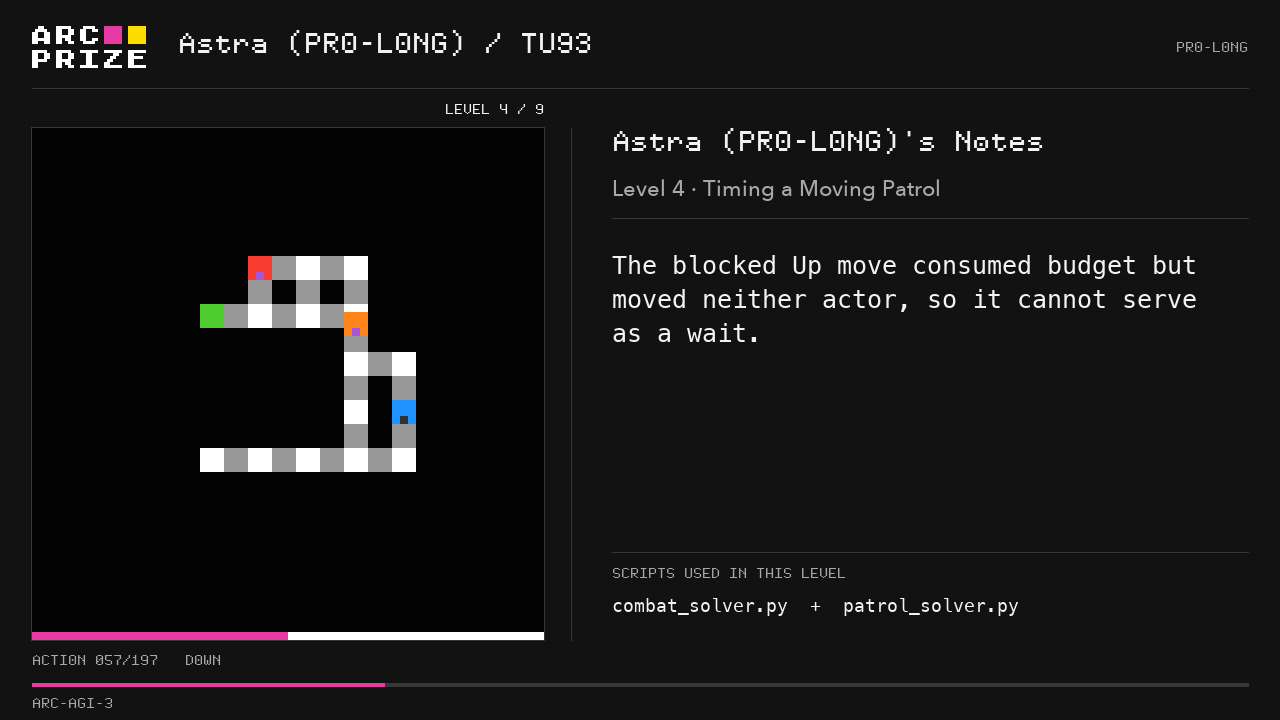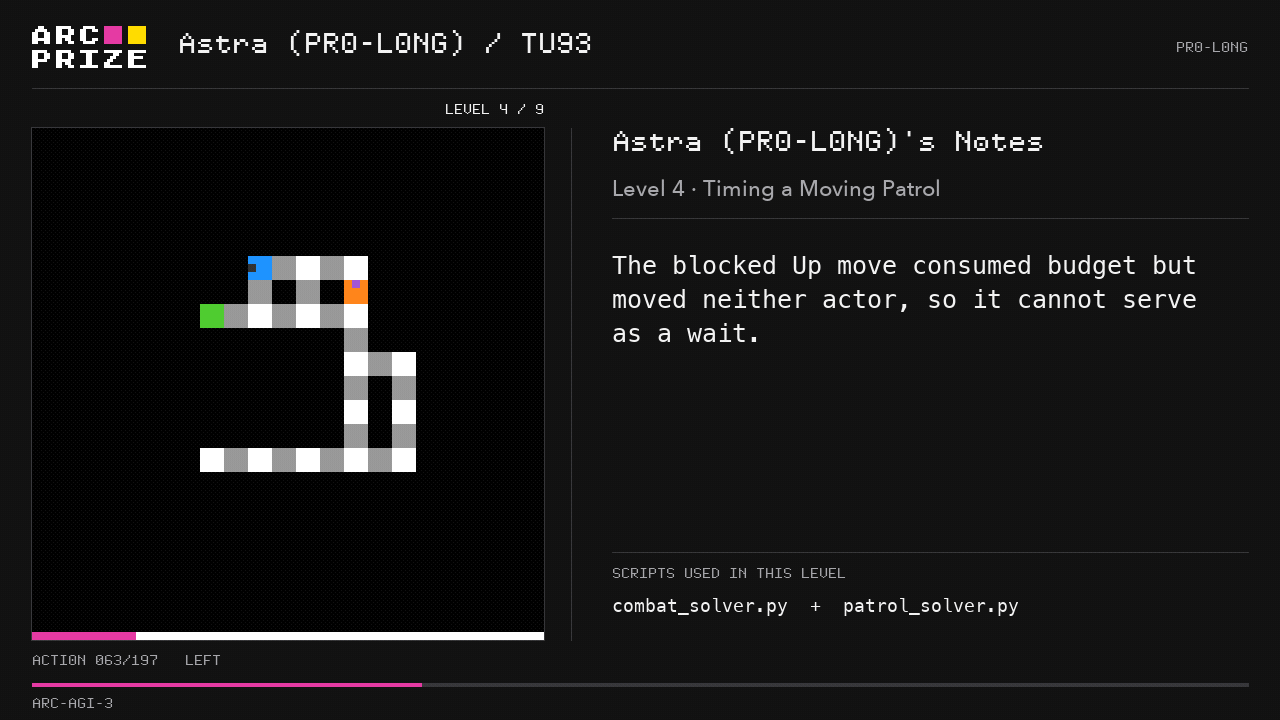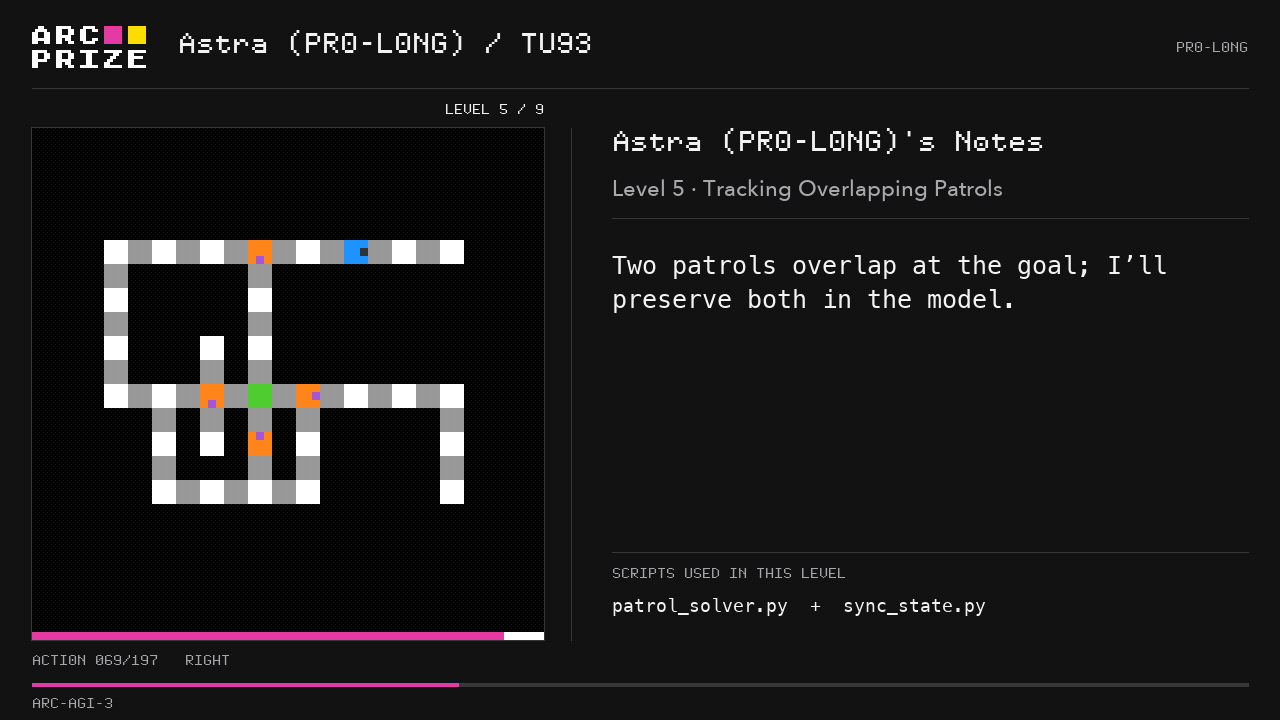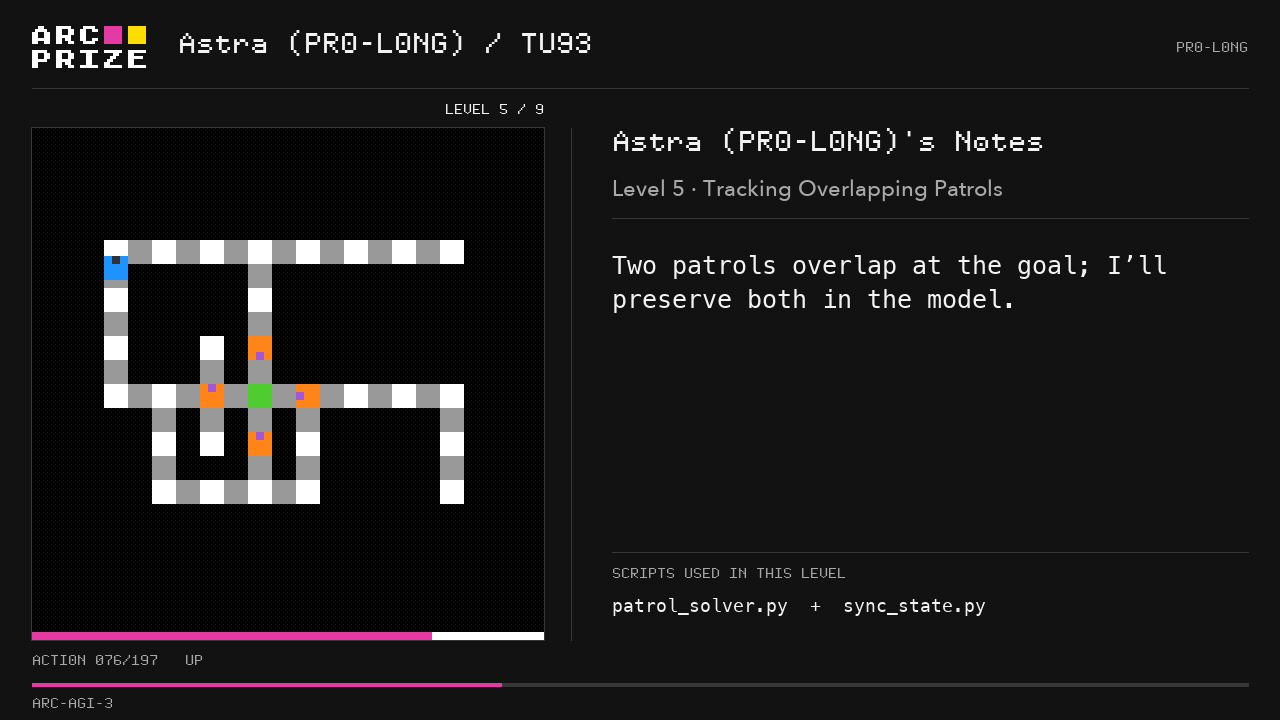
O tu93 acrescenta guardas e patrulhas móveis a um ambiente semelhante a um labirinto.[6][8] A execução abaixo usa ferramentas adicionais de programação.
Exemplo público: tu93. Um caminho no mapa pode não estar livre agora. É preciso aprender movimento, combate e patrulhas, então escolher quando agir.
Crédito da imagem: ARC Prize — Astra evaluation report; official demonstration or comparison.
Trecho da demonstração do ARC Prize com PRO-LONG, que executa código próprio. As ferramentas diferem da configuração que obteve 99,9% e das condições humanas.
É como atravessar um cruzamento movimentado: saber aonde ir não determina a hora de avançar. A próxima patrulha pode invalidar uma rota. O sistema precisa comparar previsão e observação e corrigir o plano quando divergem.
Nessa execução, o Astra escreveu auxiliares para rotas, combate e simulação de patrulhas, verificando previsões contra observações.[6][9] Isso mostra o modelo trabalhando com ferramentas, sem constituir uma competição controlada contra humanos nas mesmas condições.
O que a comparação humana mediu?
O ARC Prize recrutou aproximadamente 500 pessoas do público, sem selecionar especificamente especialistas em quebra-cabeças. Para cada fase, a referência foi a mediana do número de ações entre humanos que a concluíram.[10]
A comparação considera ações, não reflexos ou segundos. Como exemplo inventado, suponha uma referência de 20 ações: um modelo que usa 20 fica próximo dela; com 40, termina, mas dá mais voltas. Esses números ilustrativos não são dados do estudo.
Não há notas agregadas separadas para público, especialistas e equipes. Existe essa referência testada, e não devemos preencher as outras categorias por conta própria.
Crédito da imagem: OpenAI — GPT-6 Astra release; official evaluation chart.
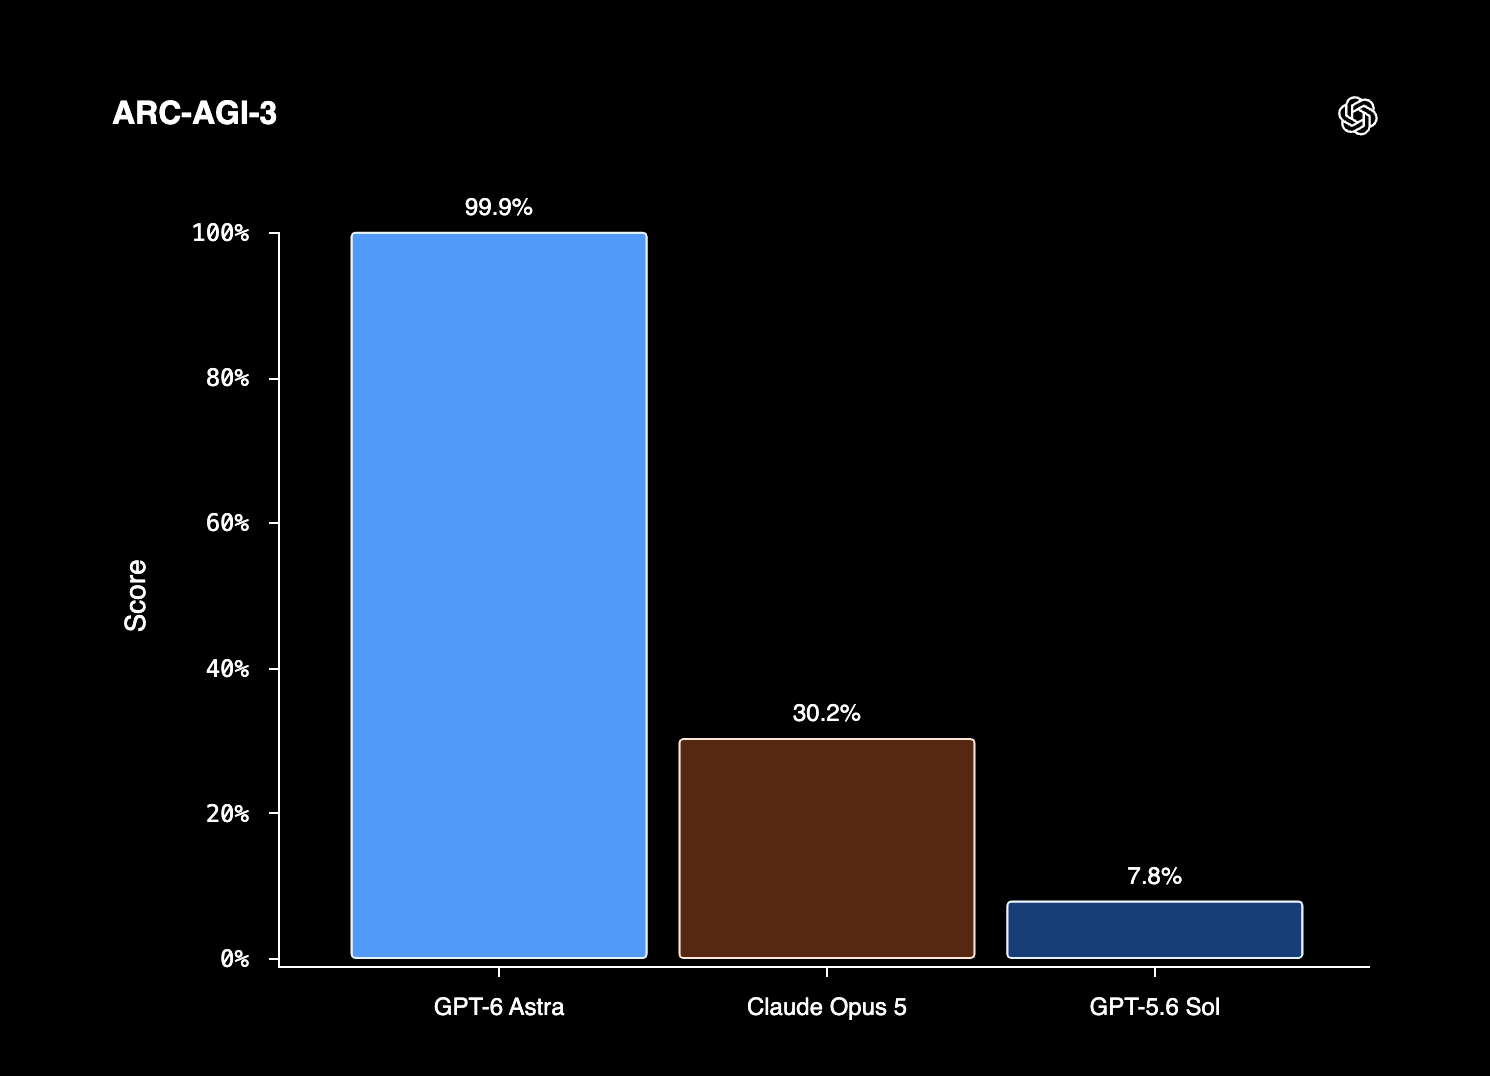
Gráfico completo da OpenAI: Astra 99,9%; GPT-5.6 Sol 7,8%. Resultados de avaliações configuradas, não de duas conversas casuais.
Voltando ao 99,9%
A diferença para 7,8% é grande.[2] Mas o ARC-AGI-3 não conta apenas alternativas corretas. A pontuação considera sucesso e eficiência de ações em relação aos humanos, com maior peso nas fases posteriores. O projeto descreve a nota máxima em termos de concluir jogos com eficiência de ações no nível humano.[5][10]
Outro detalhe merece atenção: trocar o programa ao redor do mesmo modelo muda o resultado.
O Provider Adapter é um programa de avaliação adaptado aos recursos do modelo. Provider refere-se aqui à OpenAI; o adaptador conecta o Astra ao ambiente. Não é outro modelo nem outro conjunto de perguntas.[6]
Imagine que você acabou de descobrir um padrão após testar controles. Na próxima jogada, quer continuar desse ponto. O programa padrão permite preservar anotações escritas; o adaptador também leva adiante o estado interno de raciocínio entre solicitações e compacta conversas longas. Ambos preservam informações úteis; diferem no que conseguem carregar além das notas visíveis.
O melhor resultado padrão foi 62,7%; com o adaptador, 99,9%. Esses máximos foram obtidos em níveis de raciocínio diferentes. No nível max, o adaptador obteve 98,6%; o 99,9% veio do nível high.[6]
É como avaliar o mesmo aluno com regras diferentes para conservar seu rascunho: a nota pertence ao aluno e às condições da prova. A analogia trata da continuidade do trabalho, não de receber respostas do adaptador. O resultado vale para o sistema avaliado, não automaticamente para qualquer maneira de acessar o Astra.
“96% das fases” significa “96% das pessoas”?
Crédito da imagem: ARC Prize — Astra evaluation report; official demonstration or comparison.
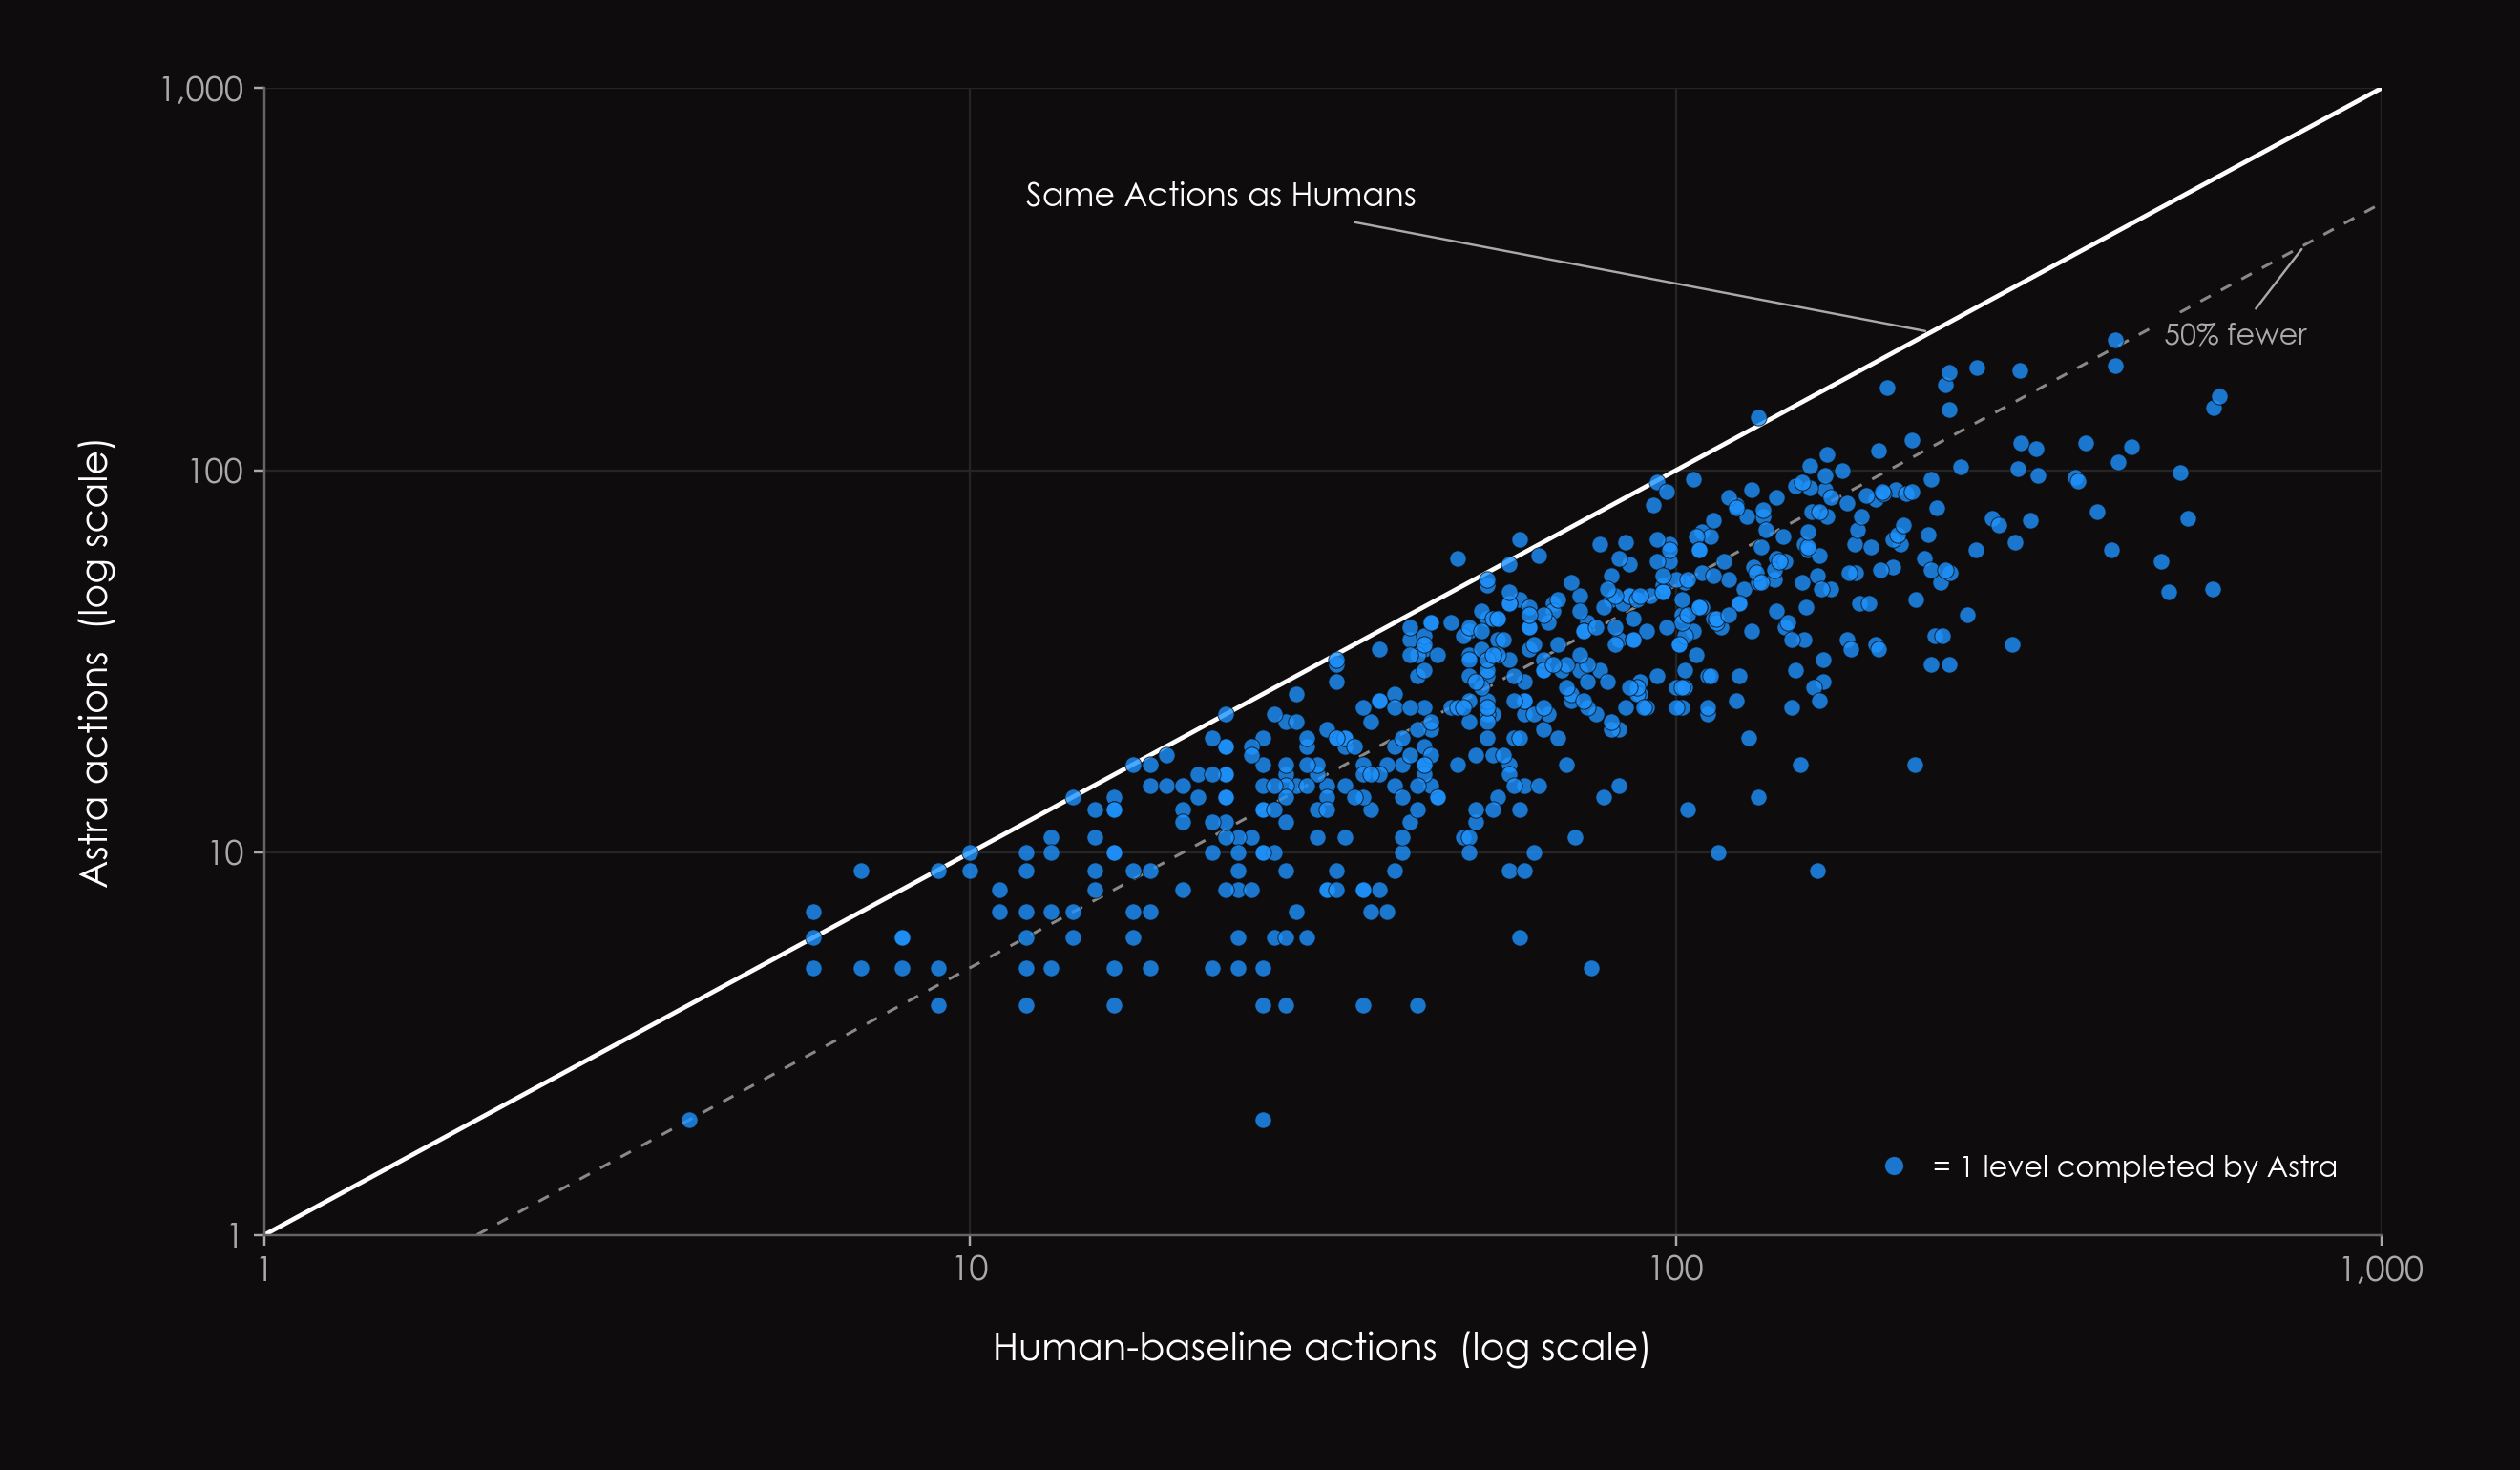
ARC Prize: cada ponto é uma fase. Abaixo da linha de referência, o modelo usou menos ações. A comparação utiliza o adaptador no nível max.
O relatório informa menos ações que a referência humana em 96% das fases.[6] Conta fases, não pessoas derrotadas. E compara com a mediana dos humanos bem-sucedidos, não com o humano mais rápido em cada fase.
Mantenha as condições juntas: 99,9% é a nota em high; a comparação de 96% usa max, cuja nota geral foi 98,6%. São afirmações compatíveis, mas não descrevem uma execução idêntica.
Há motivo concreto para interesse: em muitos desses ambientes desconhecidos, o Astra encontrou caminhos de sucesso sem precisar de muito mais tentativa e erro que a referência humana.
Um resultado forte, uma questão em aberto
Os organizadores não declaram que a AGI chegou. Mesmo jogos desconhecidos têm regras e objetivos projetados. No trabalho real, instruções podem estar incompletas, documentos se contradizem e prioridades mudam. Às vezes, primeiro precisamos combinar o que seria um bom resultado.
Imagine entregar à IA um projeto parado há seis meses. Ela precisa identificar informações ausentes, perceber quando pedir uma decisão e recuperar-se de erros. Algumas escolhas admitem várias respostas defensáveis. É um desafio mais amplo que um jogo com condição de conclusão definida.
O artigo do ARC-AGI-3 afirma explicitamente que atingir o máximo não provaria AGI.[10] O avanço merece atenção. A nota não é a porcentagem de todo trabalho real que o modelo consegue fazer nem a probabilidade de ele ser uma inteligência geral.
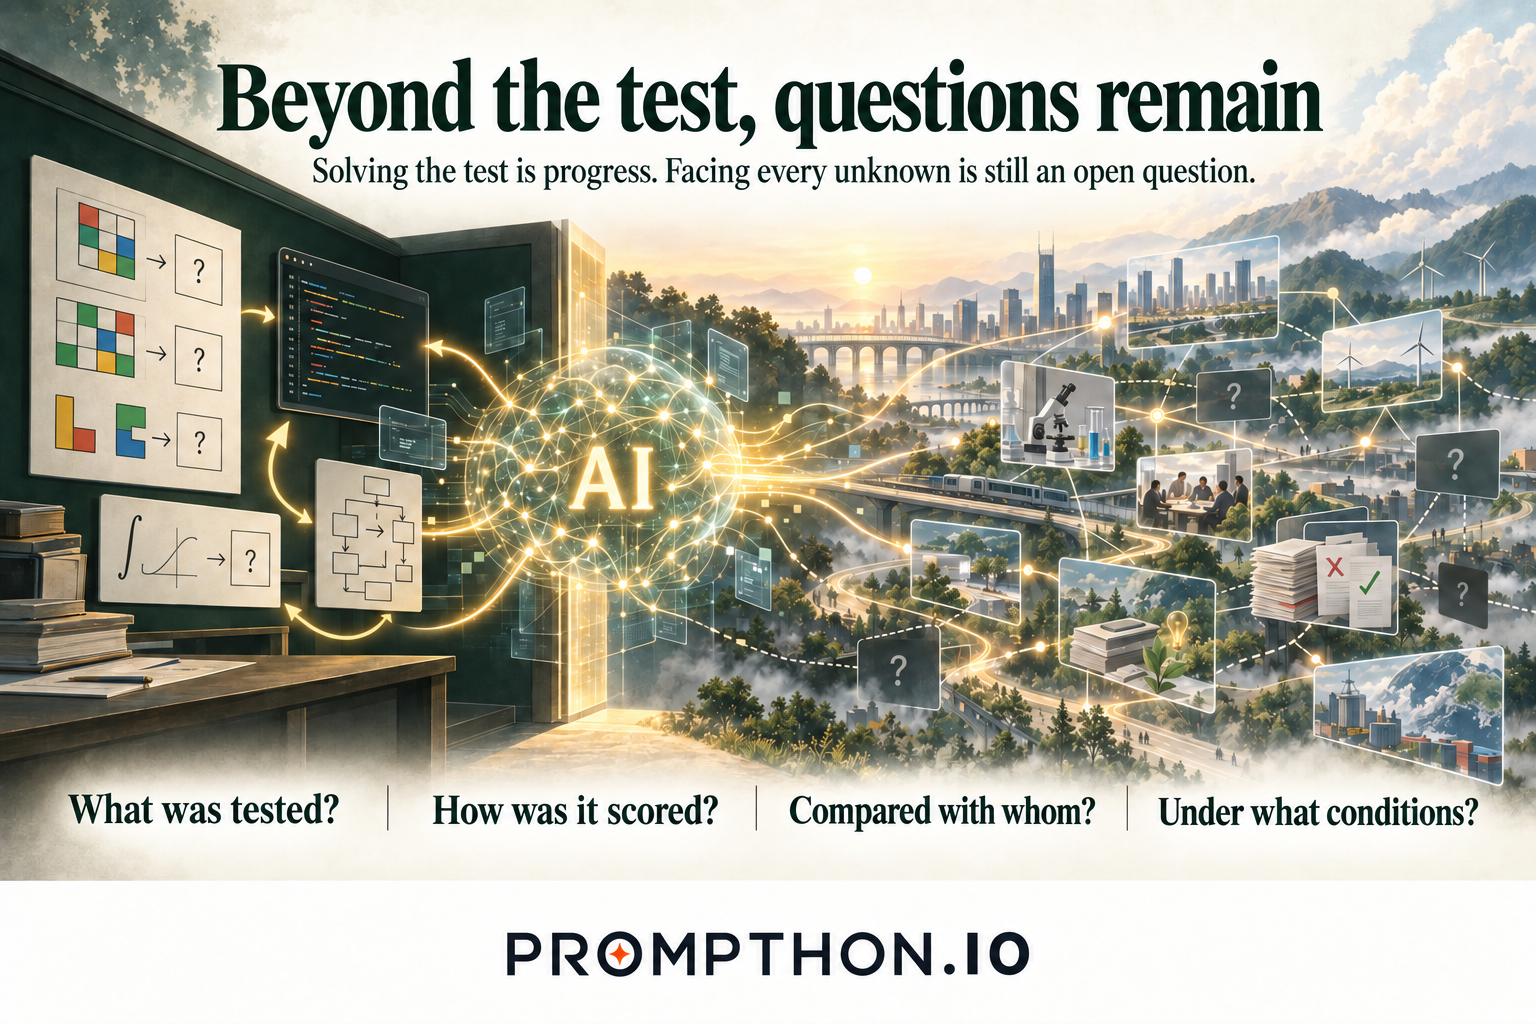
O hábito útil desta série é perguntar: o que foi testado, como se calculou a nota, com quem se comparou e sob quais condições?
Crédito da imagem: Prompthon editorial artwork.
Ilustração editorial. Título: “Além da prova, as perguntas continuam”. A imagem contrapõe progresso em testes às incógnitas do mundo real. Perguntas na base: o que foi testado, como se pontuou, com quem se comparou e em quais condições.
O Astra avançou na aprendizagem nesses ambientes desconhecidos. Até onde essa capacidade se estende continua a exigir evidências.
Localizado a partir da edição chinesa publicada em 8 de setembro de 2026. Exemplos resumem tarefas e demonstrações públicas, não experimentos nossos. As notas preservam versões e configurações originais; a numeração das fontes acompanha a edição chinesa.