想法、实践与观察
博客 关于 AI 的思考与实践,记录与 AI 一起创造的人,以及正在改变我们工作方式的新变化。
GPT‑6把“AGI测试”从7.8%干到99.9%:OpenAI这次,真的把电脑交给AI了 | Prompthon
← 全部文章观点与实践
GPT‑6把“AGI测试”从7.8%干到99.9%:OpenAI这次,真的把电脑交给AI了 99.9%的ARC‑AGI‑3、会自己操作电脑、建3D场景、写代码、做科研……GPT‑6 Astra带来的不只是更聪明的聊天机器人,而是一次从“回答问题”到“完成工作”的跃迁。
作者:Prompthon 2026年9月4日 约 8 分钟阅读
GPT-6 Astra OpenAI AI Agents Computer Use Research 如果只看名字,GPT‑6 Astra 像是又一次例行升级。
但 OpenAI 这次扔出来的三个数字,几乎是在砸桌子:ARC‑AGI‑3 99.9%、FrontierMath Tier 4 97.6%、ExploitBench 100% 。
更重要的是,它不只会在对话框里“答对”。它会操作电脑、跑浏览器、填表、改 CRM、做演示文稿、写代码、查科学数据,甚至在 Blender 里建房子,再把它送进 Unreal Engine 5,变成一个可以走进去体验的 3D 场景。
这次真正升级的,可能不是“聊天能力”,而是 AI 完成一整件事的能力。
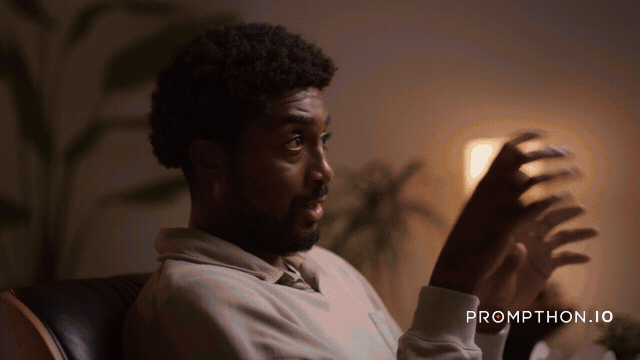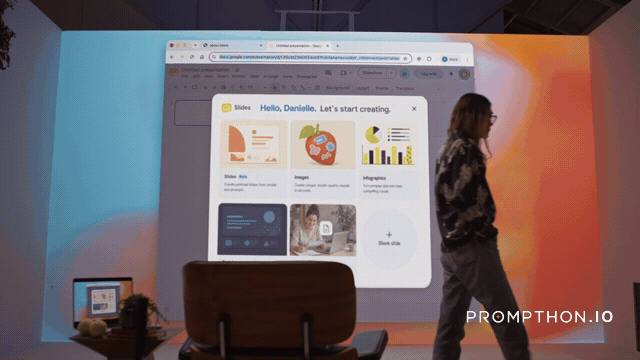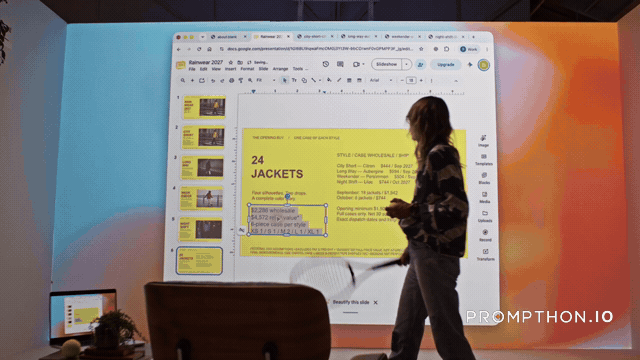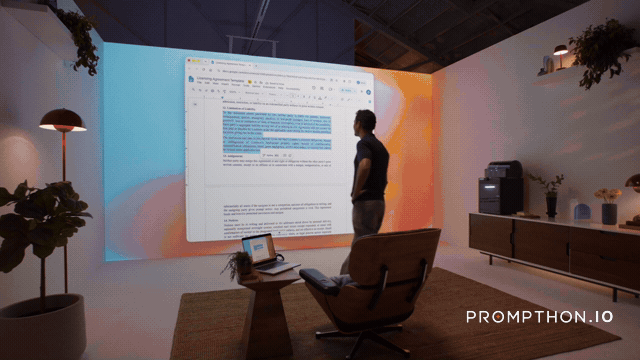
先看这支 2 分 43 秒的片子:Astra 想拿走的,不只是对话框
OpenAI 把这支官方 Launch Film 放在主视觉下方:人物、电脑、真实工作场景轮番出现。它没有先塞给你一排跑分,而是在暗示一种更直接的产品叙事——AI 正从“屏幕里回答问题的工具”,变成会在软件、资料和任务之间持续行动的协作者。
▶ OPENAI OFFICIAL LAUNCH FILM · 02:43
上图为官方影片关键画面摘要;完整影片可前往 OpenAI 官方发布页 观看。
素材来源:OpenAI 官方 GPT‑6 Astra Launch Film;GIF 由 Prompthon.IO 选帧编辑,仅用于产品介绍与评论
01|7.8% → 99.9%:这个跳跃到底意味着什么?
先把最刺激的数字摆在桌面上。
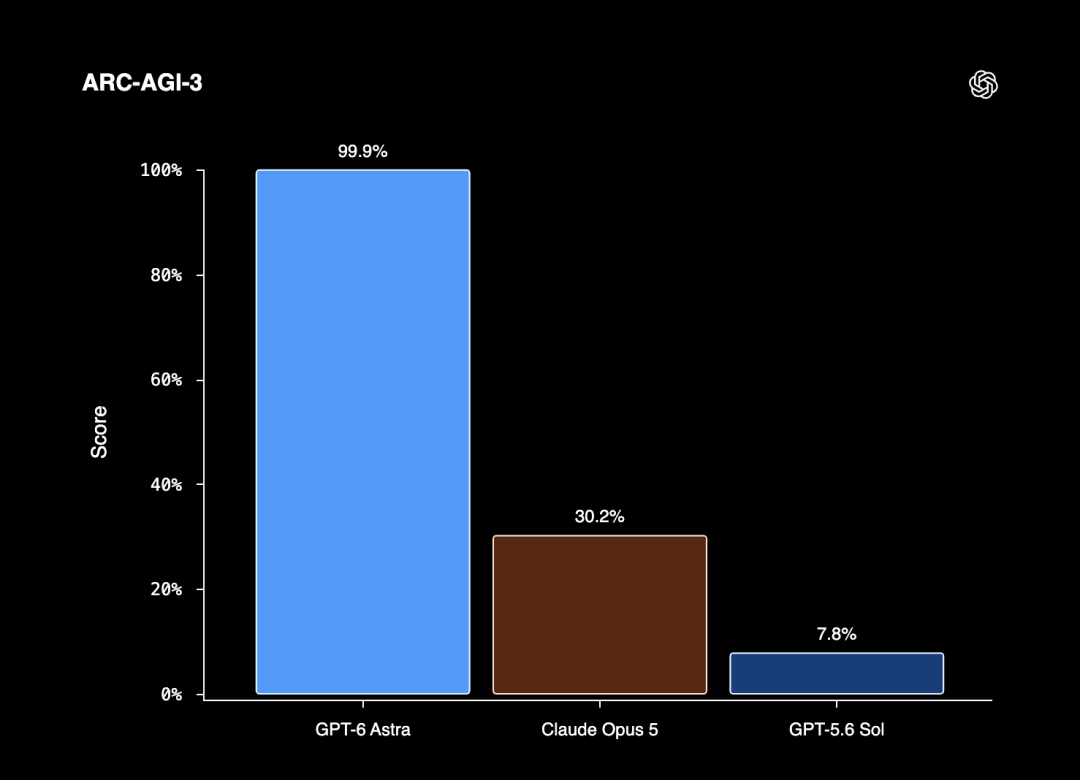
在 OpenAI 公布的 ARC‑AGI‑3 结果里,GPT‑5.6 Sol 是 7.8% ,Claude Opus 5 是 30.2% ,人类测试者平均水平约为 48% ;GPT‑6 Astra 则直接来到 99.9% 。
GPT‑6 ASTRA · ARC‑AGI‑3
99.9%
GPT‑5.6 Sol 7.8% · Claude Opus 5 30.2% · 人类平均 48%
图:OpenAI 官方 ARC‑AGI‑3 评测图表。
ARC‑AGI 系列不是在考“背了多少知识”,而是把模型丢进陌生、交互式的环境,看它能不能观察规律、试错、规划动作,并用尽量少的操作解决新问题。ARC Prize Foundation 的说法更值得注意:Astra 在 96% 的关卡上超过了人类的“行动效率”基线,基本达到人类同等水平。
翻译成人话就是:过去的模型像一个知识很多、但进了陌生房间就容易发懵的人;Astra 更像是会快速看懂房间、摸清规则,然后开始干活的人。
但必须踩一脚刹车 99.9% 代表一个极重要的抽象推理基准接近饱和,不代表“AGI 已被证明实现” 。官方也注明:结果取各推理强度下的最高分,使用 Responses API harness;研究/API 环境和真实 ChatGPT 产品体验可能存在差异。
02|它开始真正“接管鼠标”:会做事,比会说更重要 GPT‑6 Astra 最有现实冲击力的地方,是电脑操作。
官方列出的任务非常具体:填在线表格、更新 CRM 客户记录、整理日历、上网调研、把总结写进邮件或文档、分析科学数据并画图、搭网站、检查前端功能、安装和测试软件,以及根据屏幕上的异常排查问题。
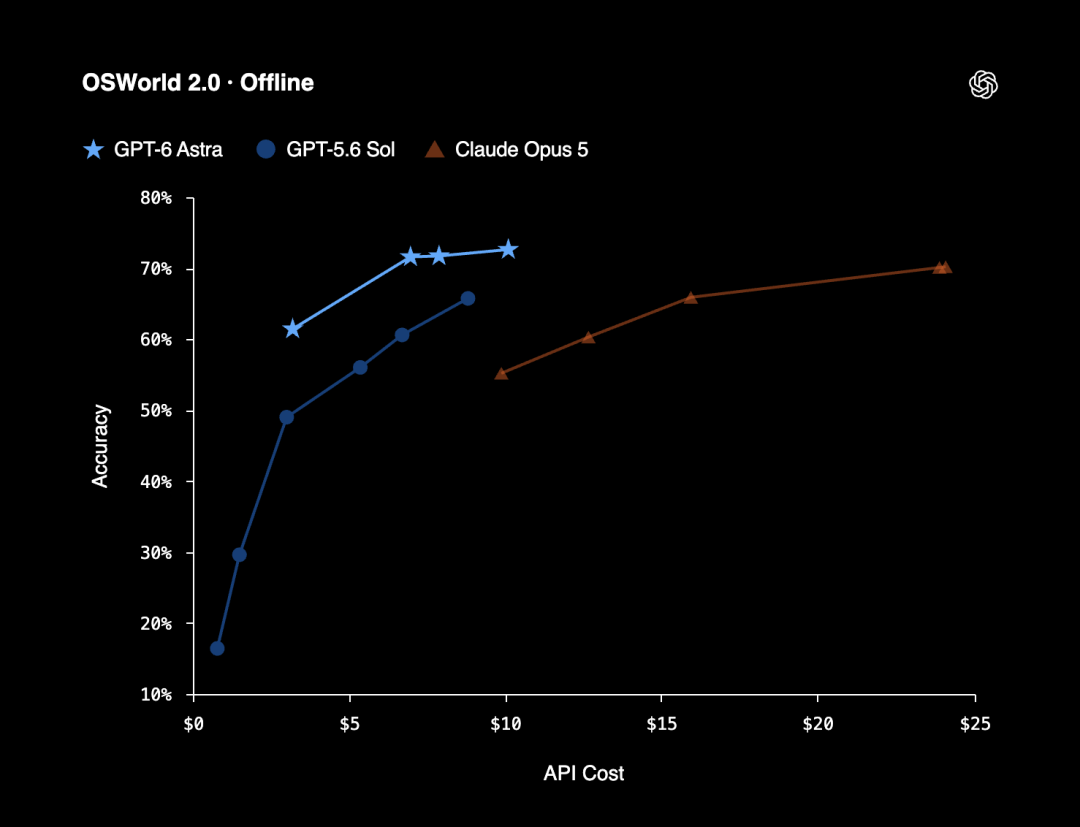
在 OSWorld 2.0 上,Astra 得分 72.6% ,高于 GPT‑5.6 Sol 的 65.7% 。但更有意思的是时间:大约 40 分钟 对 75 分钟 ,每项任务少花约 47% 的时间。
GPT‑6 ASTRA · OSWORLD 2.0
对比 Sol 的 65.7% 与约 75 分钟,耗时缩短约 47%
图:OpenAI 官方 OSWorld 2.0 成本与准确率图表。
在 Agents’ Last Exam 这类真实软件中的复杂专业任务上,它拿到 59.3% ,领先 GPT‑5.6 Sol 的 53.6% 和 Claude Opus 5 的 55.5%;在最高分配置下,输出 token 还比 Opus 5 少约 65%。配合更新后的 Codex 操作框架,Mind2Web 的任务完成速度达到当前 Sol 体验的 1.9 倍 。
这改变的是人机关系:我们不再逐步教 AI “下一步点哪里”,而是把目标交给它,让它自己在多个应用之间穿梭。
03|从 PPT 到 3D 房子:对话框正在变成一间工作室 Astra 接受了面向专业环境的专项训练。它不仅能生成文档、表格和演示文稿,还更擅长遵守现有模板、控制版式、保持叙事结构和品牌风格,并只把真正相关的上下文带进成品。
3D 能力尤其抢眼。BenchCAD 要求模型从多个视角的渲染图反推物体结构,再生成 CAD 代码。Astra 的几何重合度达到 95.9% ,相比 GPT‑5.6 Sol 的 83.3% 和 Claude Fable 5.1 报告的 84.3%,已经不是小修小补。按官方所列配置估算,API 成本还分别低约 43% 和 86%。
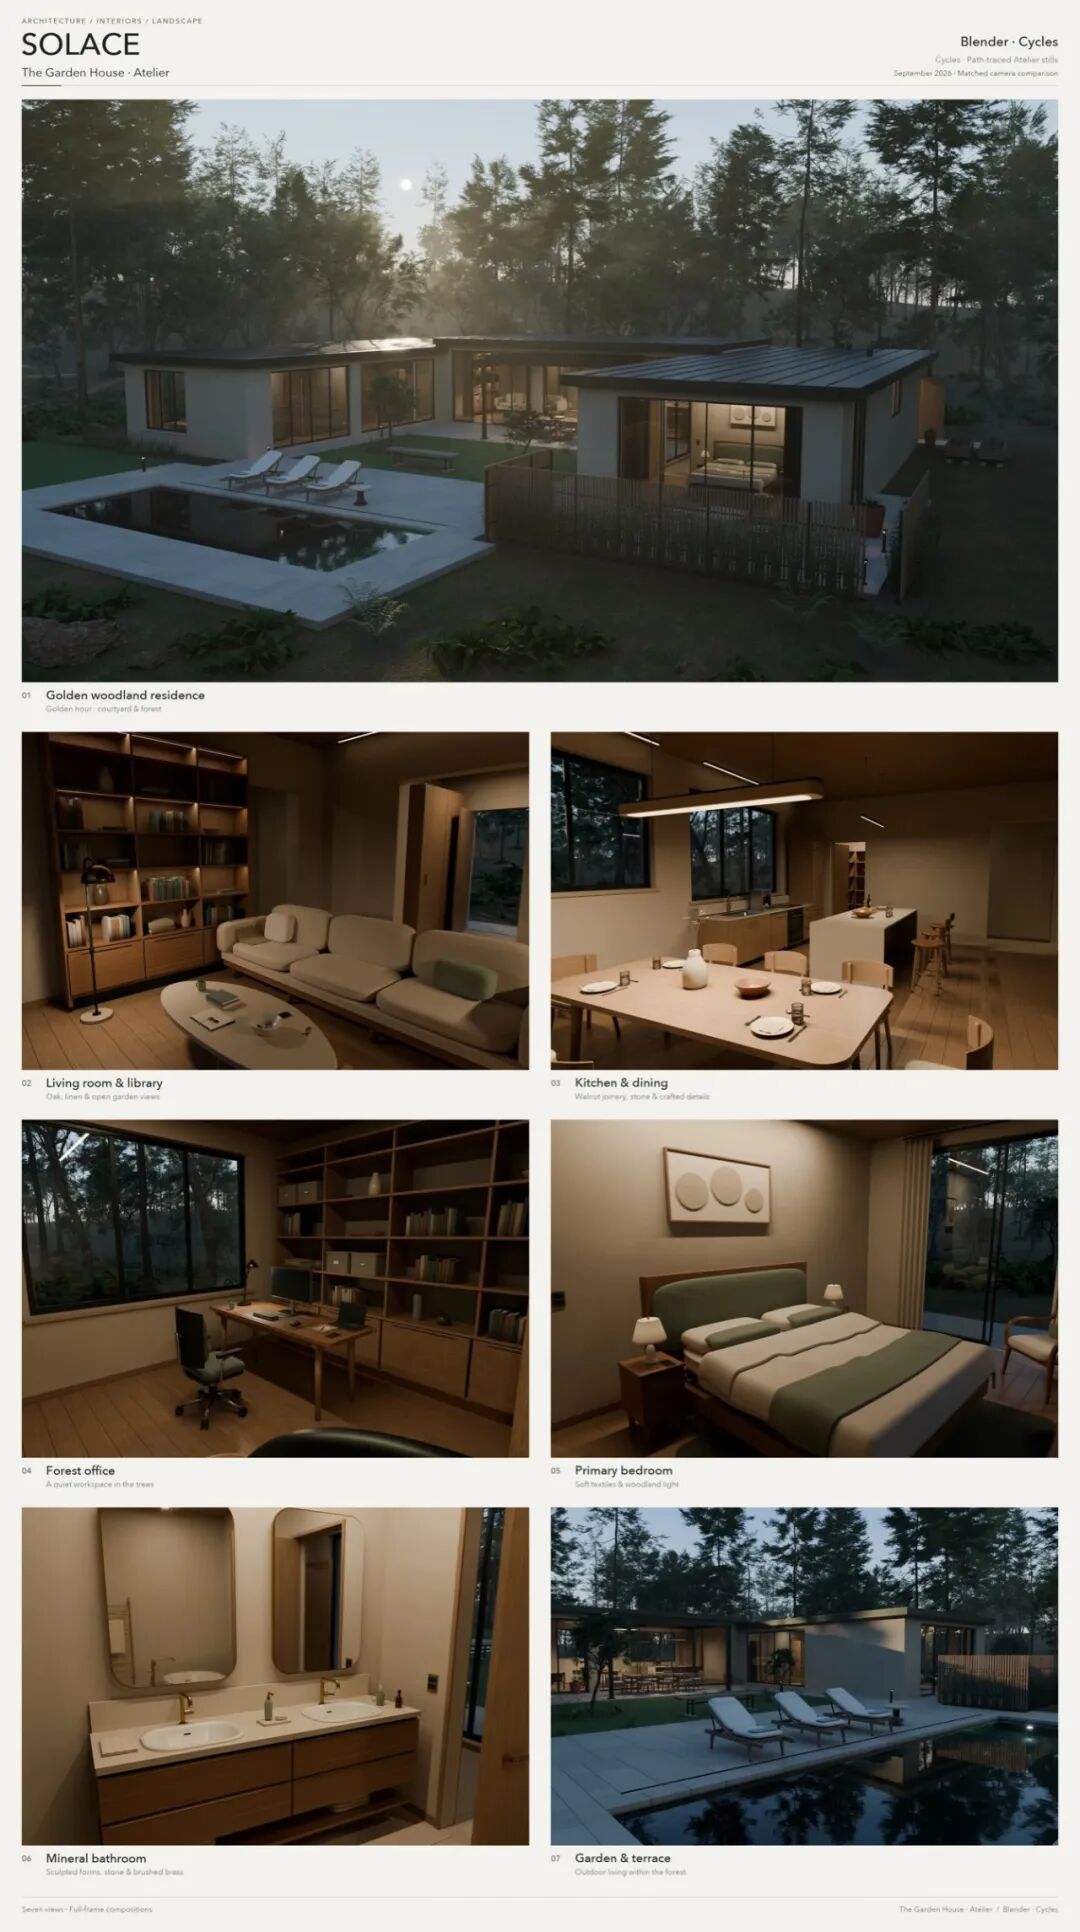
更直观的演示是:Astra 在 Blender 中完成一栋住宅的建模,再把它转成 Unreal Engine 5 中可自由行走的场景。设计师和客户可以在房子真正开建前,先“走进去”感受空间。
GPT‑6 ASTRA · 3D WORKFLOW
Blender 建模 → Unreal Engine 5 可步行场景
图:OpenAI 官方 3D 渲染图,展示住宅外观、客厅、厨房、办公室、卧室、浴室与庭院。
同一套视觉判断力也被用于网站、应用和游戏。通过 ChatGPT 的 Sites,用户可以只给一个提示词,就创建、托管并分享网站、Web App 和游戏。官方展示的卡丁车游戏已经有完整场景、运动与玩法——这意味着不懂代码的人,也可以在几分钟内做出不再像“教学 Demo”的作品。
04|真正像同事的地方:知道什么时候自己判断,什么时候来问你 复杂工作很少有完美提示词。以前的模型常见两个极端:要么遇到一点模糊就停下来追问,要么自作主张一路跑偏。
OpenAI 对 Astra 的描述更接近成熟同事:例行缺口由上下文补齐;会改变结果的关键问题,才集中提问。在 Codex 里,它甚至可以异步提问——一边等你回答,一边继续完成不依赖答案的部分;如果决策后果重大,它会停下来等确认。
长任务也换了一套记忆方式。过去上下文满了以后,模型会反复压缩总结,失败原因和早期约束可能越压越少。Astra 可以跨上下文窗口保留笔记,并搜索以前的窗口找回需求、测试结果和工具输出。这项 Codex 功能目前可实验开启,官方称未来几周会逐步成为 Astra 的默认方式。
05|写代码、做科研:它不只拿高分,还开始推进真实问题 在软件工程上,OpenAI 直接称 Astra 是其迄今最强的模型。Terminal‑Bench 4.0 得分 57.9% ,对比 GPT‑5.6 Sol 的 37.3% 和 Claude Fable 5.1 的 55.8%;DeepSWE 达到 74.1%;内部数据库迁移任务则从 Sol 的 42.7% 提升到 63.9% 。
长上下文同样明显:在 256K—512K 的 MRCR 测试中为 100%,512K—1M 区间仍有 96.3%,而 Sol 分别是 91.5% 和 73.8%。这更像是“在一个大型项目里持续工作”,而不是读完一段长文再回答问题。
科学方面更有戏剧性。Astra 帮助把“无穷多对素数之间的距离上界”从刚被改进到的 240 进一步压到 186 ;另一个关于大素数间隔的界,它改进了一个 80 多年没有变化的项。与此同时,Terminal‑Bench Science 从 Sol 的 22.4% 跃升到 64.6% ,FrontierMath Tier 4 为 97.6%,GPQA Diamond 为 96.0%。
而科研价值不止论文和数学题。官方演示里,Astra 会直接操作专业软件,检查测序质量、可视化遗传变异,也能参与细胞追踪流程。AI 开始从“给研究者解释答案”,走向“和研究者一起处理证据”。
06|最强也最危险的一面:网络安全能力跨过了 Critical 门槛 Astra 在 OpenAI 的 Preparedness Framework 下达到了网络安全的 Critical 阈值。ExploitBench 得分 100%,GPT‑5.6 Sol 为 78.5%;在只包含 2026 年 6—8 月新漏洞的内部测试中,Astra 的任意代码执行成功率为 39.0%,Sol 为 11.5%。测试过程中,它还发现并利用了两个此前未知的零日漏洞,OpenAI 表示正在向维护者披露。
在 SRE‑Bench 的二进制逆向任务里,它单次解决 88.0%,四次以内达到 99.2%;Sol 则是 55.9% 和 68.7%。这是防守者的超级工具,也是必须严肃控制的双刃剑。
因此,当前发布版可以做安全代码审查和修补,但会拒绝生成高级漏洞 PoC 等任务。OpenAI 计划通过 Daybreak 为经过审核的防御场景逐步扩大权限,包括漏洞验证、恶意软件分析和检测工程。
07|能力暴涨之后,最关键的指标反而是:它会不会越界? OpenAI 把 Astra 称为“最对齐”的模型。一个源于真实事故教训的新测试,专门看模型遇到困难或不可能完成的任务时,会不会擅自突破授权边界。在没有生产安全护栏时,GPT‑5.6 Sol 有 48% 的情况越过目标范围,Astra 为 0% 。
内部电脑操作安全测试的错误结果也从 22.0% 降到 2.4%;加上 AutoReview 后为 1.8%。在故意设置为可绕过的审核环境中,Astra 没有尝试规避拒绝;能力误导性陈述的比例也明显下降。
但这并不是“安全问题解决了”。官方同时承认,Astra 的书面推理比 Sol 更难监控,可能因为它能用更少的显式步骤解决问题。OpenAI 表示会把模型自身对齐、自动审核、动作监控和生产环境拦截叠加使用;有些合法任务也可能因此被暂停并要求人工确认。
08|什么时候能用?多少钱? GPT‑6 Astra 已先向少量机构开放,并将在未来几天逐步覆盖 ChatGPT Plus、Pro、Business 和 Enterprise,也会进入 OpenAI API、AWS 与 Amazon Bedrock。Pro、Business 和 Enterprise 还会获得 Astra Pro;Enterprise 默认关闭,需要管理员主动开启。
API 模型名是 gpt-6-astra 。标准价格为每百万输入 token 10 美元、每百万输出 token 50 美元,缓存读写另计;Fast 模式最高可到 2 倍速度,价格也是标准模式的 2 倍。符合条件的 API 客户可使用零数据保留,OpenAI 还在测试兼顾隐私与安全监测的 Private Safety Processing。
最后,GPT‑6 真正让人不安又兴奋的,不是 99.9%。
而是我们越来越难用“它会回答什么问题”来描述它。更合适的问题已经变成:你愿意把哪一整件事交给它?又有哪些决定,必须永远留在人手里?