观点与实践
参与造出 ChatGPT 的人,为什么又做了一个不会聊天的 Jev?
从 InstructGPT、函数调用和结构化输出的历史,看 Jev 为何专注快速判断,以及格式正确与业务可靠之间的距离。
2026 年 9 月 15 日,Diogo Almeida 在新公司的发布文章里,重新提起了自己在 OpenAI 做过的工作:帮助语言模型学会按照人的指令回答问题。
这一次,他交出的产品却不负责写文章,也不陪人聊天。
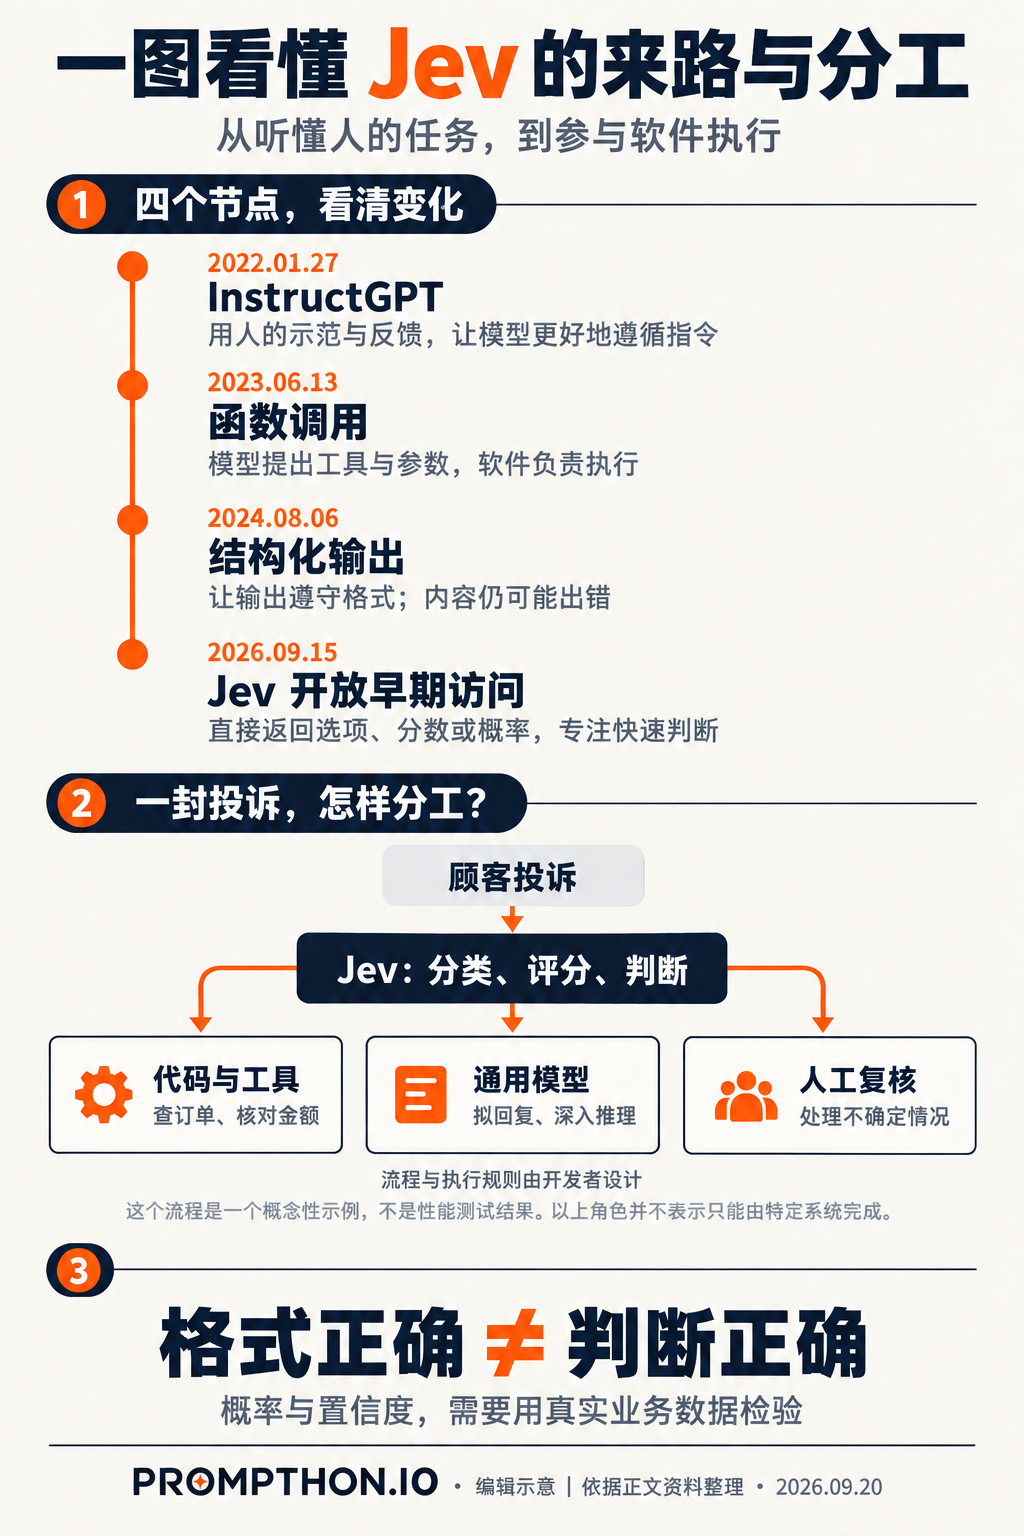
它叫 Jev。你把当前情况和需要判断的问题交给它,它返回选项、分数或概率,让软件继续往下运行。[1]
这个反差很容易被讲成“ChatGPT 的创造者推翻了自己”。但如果顺着历史往回看,故事要有意思得多:当年要解决的是模型能不能听懂人,如今要追问的是,听懂之后,软件能不能放心接着干活。
读懂 Jev,要看清这几年 AI 怎样从“回答问题”走向“参与执行”。这也能帮我们判断:哪些工作值得交给快速决策模型,哪些仍需要更深入的推理和人工把关。
先把时间拨回 2022 年:会接话,还不等于会听话
2022 年 1 月 27 日,OpenAI 介绍了 InstructGPT。那时的一个问题是:语言模型擅长顺着已有文字往下写,但用户交给它的任务,不一定能被好好完成。[2]
想象一家网店收到投诉。你希望模型概括顾客遇到的问题,它却可能把投诉当成故事的开头,接着往下编。语言通顺,任务却没做对。
InstructGPT 的办法,是先让人示范怎样回答,再让人比较不同回答的好坏,把这些反馈用于训练。这类方法叫“基于人类反馈的强化学习”,简称 RLHF。用大白话说,就是让模型从人的示范和评价里,学习什么样的回答更符合要求。
同年 3 月 4 日公开的论文中,Almeida 是共同作者之一。论文也没有把这条路包装成终点:模型更符合用户意图了,仍然会犯简单错误。[3]
这段历史值得保留。把当年的研究简单说成“教 AI 讨好人”,会漏掉它真正解决的问题。我们今天习以为常的“交代任务,让模型照着做”,当时本身就是需要攻克的一步。
可当模型进入客服系统,新的问题就来了。
它能解释“这位顾客可能需要退款”,不代表程序已经知道下一步该把工单送到哪里、该查询哪笔订单,以及什么情况下必须找人确认。
2023 到 2024 年:大家已经在给模型接上软件
2023 年 6 月 13 日,OpenAI 发布函数调用能力。开发者可以告诉模型有哪些工具、各自需要什么参数,让模型返回程序能读取的调用信息。[4]
沿用网店的例子:顾客问包裹到哪了,模型可以提出调用“查询物流”,并填入订单信息。实际查询仍由软件执行。
到 2024 年 8 月 6 日,OpenAI 又推出结构化输出,进一步约束返回结果遵守开发者规定的格式。[5]
比如工单分类只能从“物流、退款、商品咨询”中选择,就需要让程序稳定地拿到这些规定的值。官方同样提醒:格式符合要求,内容仍可能出错。
所以,让 AI 的输出可以接进软件,并不是 Jev 首次提出的事情。这几年,通用语言模型一直在沿着这个方向改进。
Jev 把问题又往前推了一层:对于只需要选择、评分和判断的环节,还需要逐字生成一份回答吗?
这里也要区分两件事。让模型按格式输出,解决的是“交付什么形状的答案”;专门为快速决策设计模型,还要解决“怎样更省时间、更省成本地得到它”。
前面的进步是真实的,后面的空间也可能存在。
到了 2026 年,Almeida 把注意力放在了另一种答案上
在 Jev 的发布文章中,Almeida 回顾说,离开聚光灯的两年里,TypeSafe 团队围绕自动化开发了新的模型架构、采样方式和训练方法。他关心的问题是:聊天能力已经很强,为什么许多事情仍不能可靠地自动完成?这是他的创业判断,不是行业已经达成的结论。[1]