观点与实践
GPT-6 Astra 的“高考”成绩单(下):99.9%,离 AGI 还有多远?
从两个公开游戏示例出发,看懂 ARC-AGI-3 的 99.9%、人类参照与运行配置,以及它们为什么还不能证明 AGI。
七门考试看完,压轴的那张成绩单,终于该拿出来了。
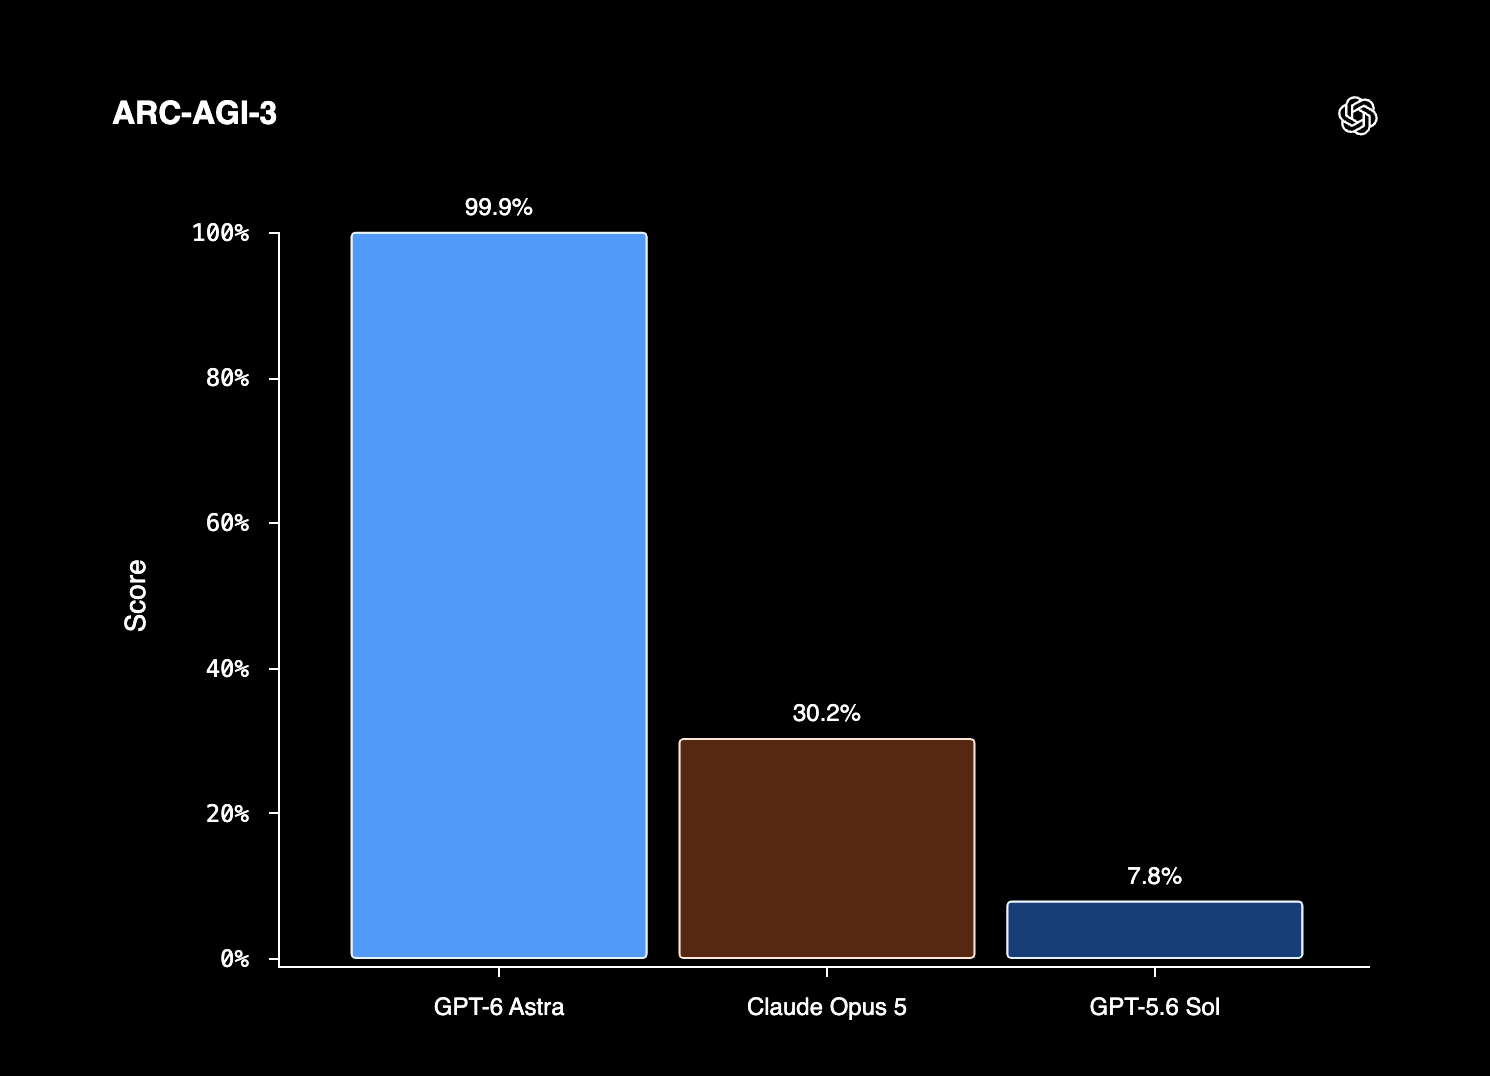
99.9%。
2026 年 9 月 3 日,OpenAI 发布 GPT-6 Astra。伴随着“欢迎来到 AGI 时代”的宣告,这个接近满分的数字,成了最让人忍不住追问“难道真到了”的成绩之一。(发布报道与官网,见参考资料 [1]、[2])
上篇,我们看了科学、数学、编程和专业工作。下篇只讲这一项:ARC-AGI-3。
它想追问的,比“你会做多少道题”更进一步:眼前的东西从没见过,也没人教过玩法,你还能自己学会吗?
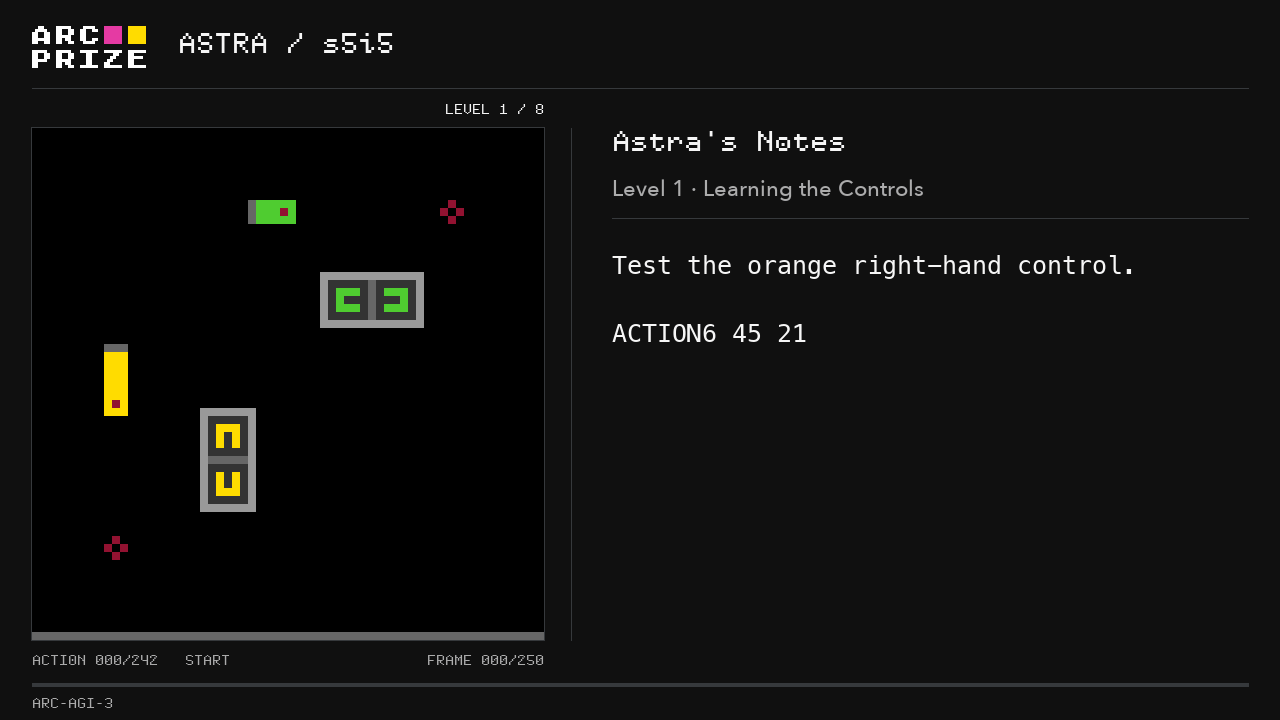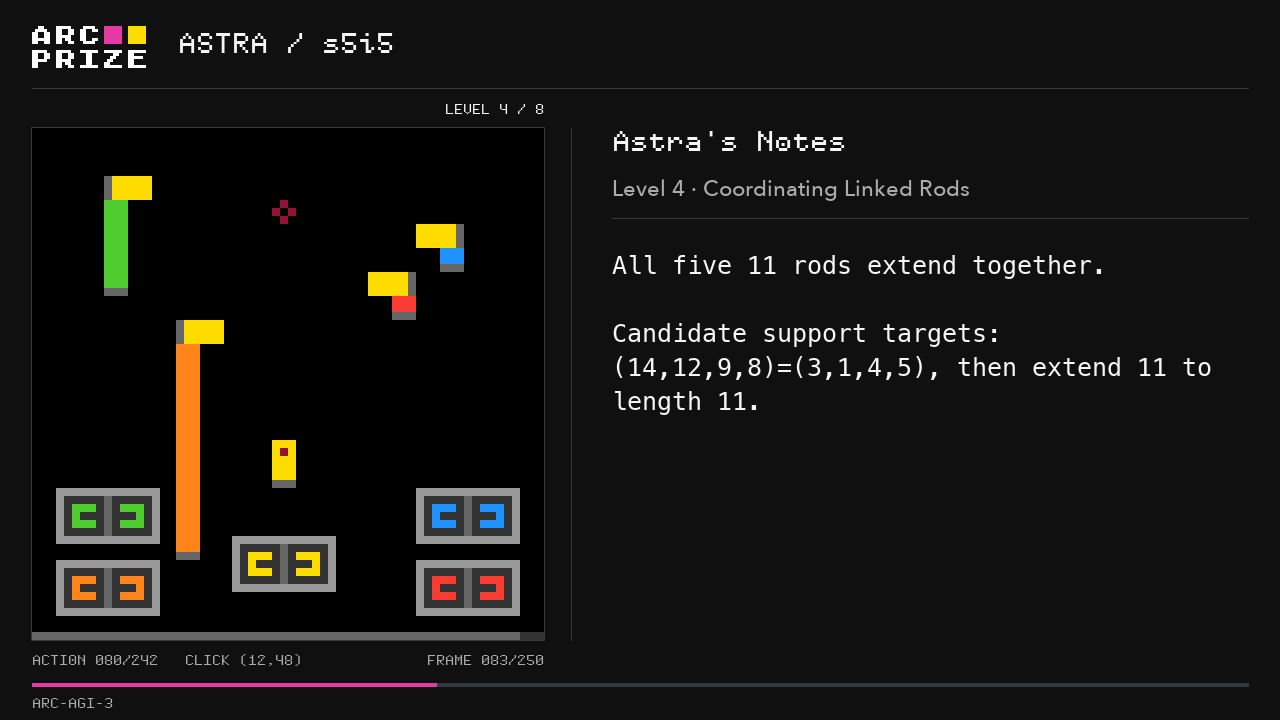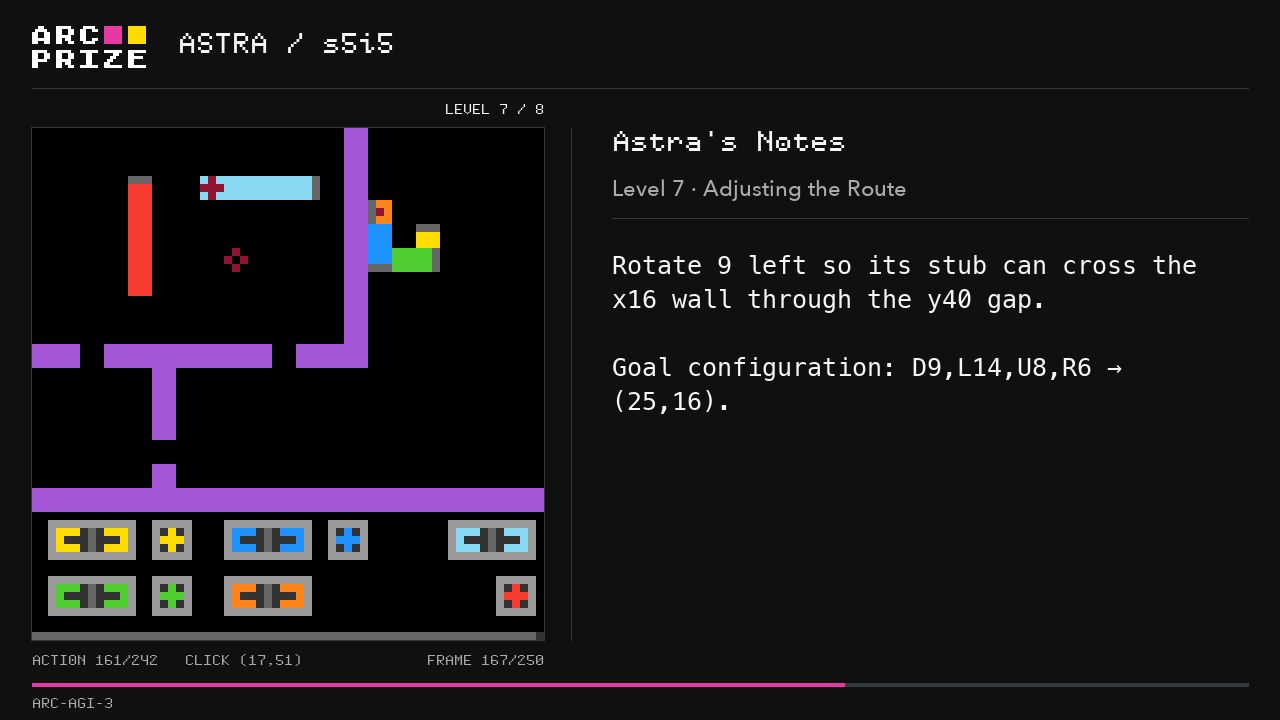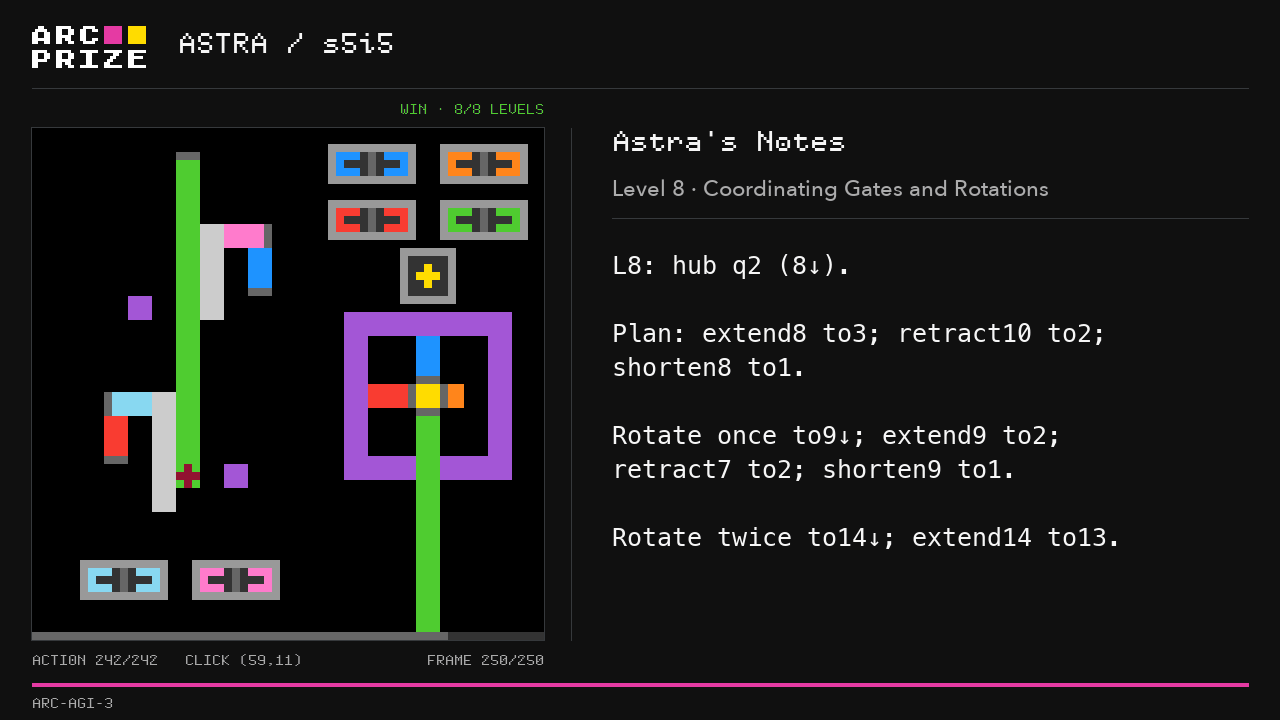
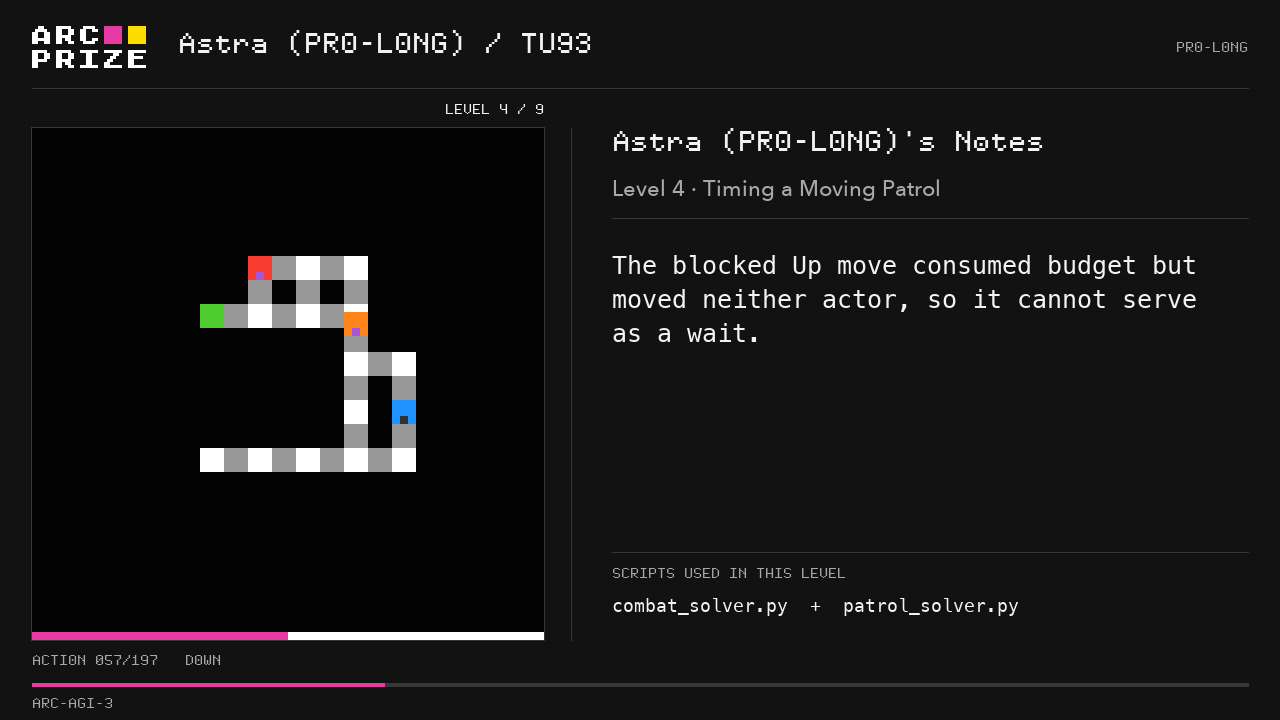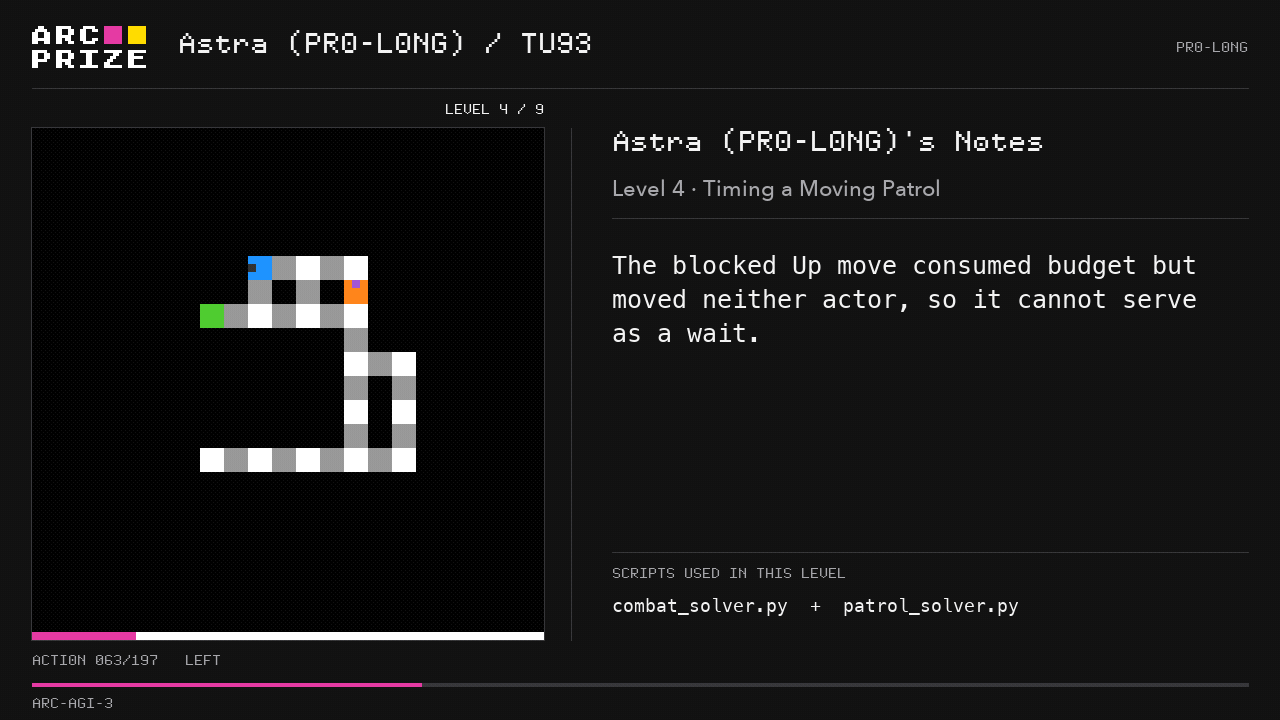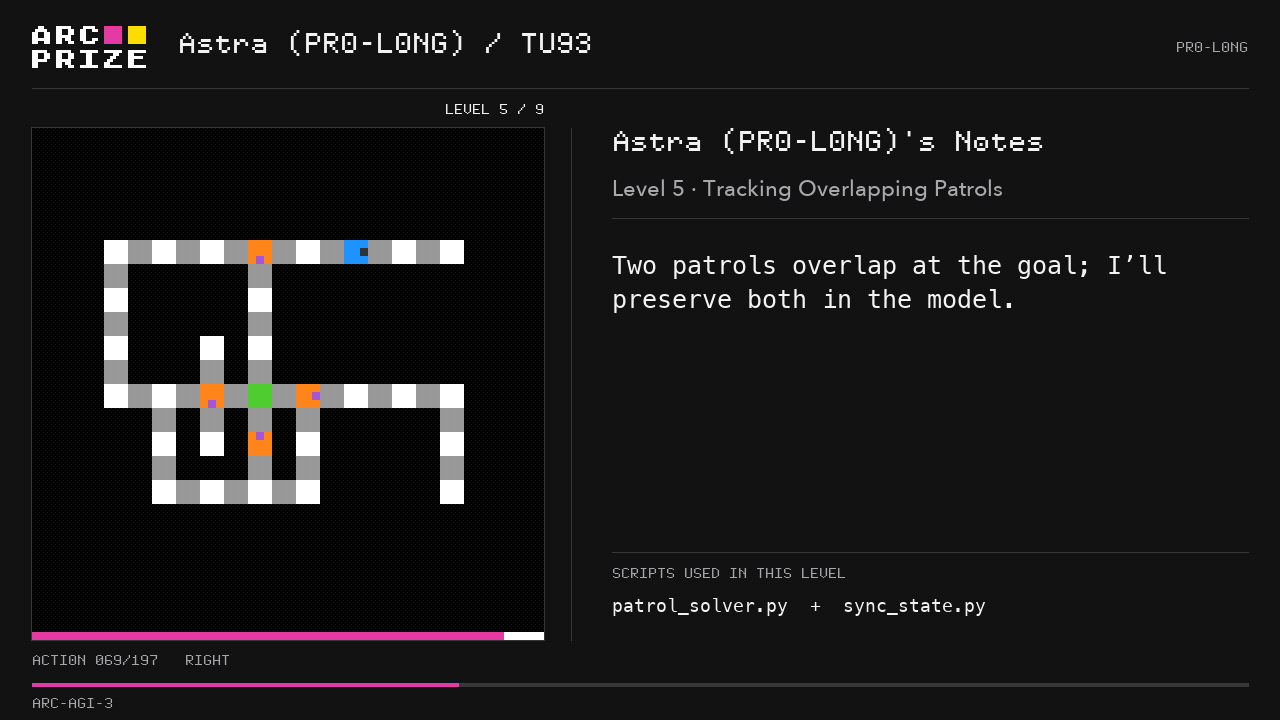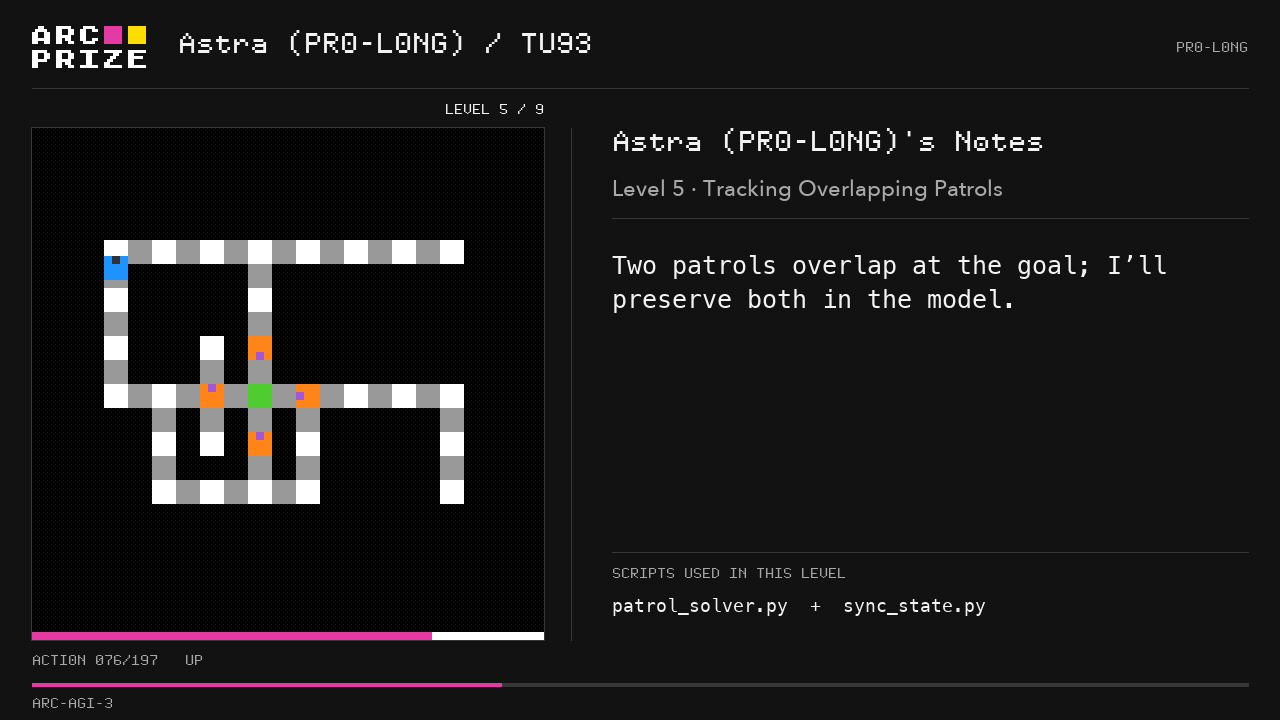
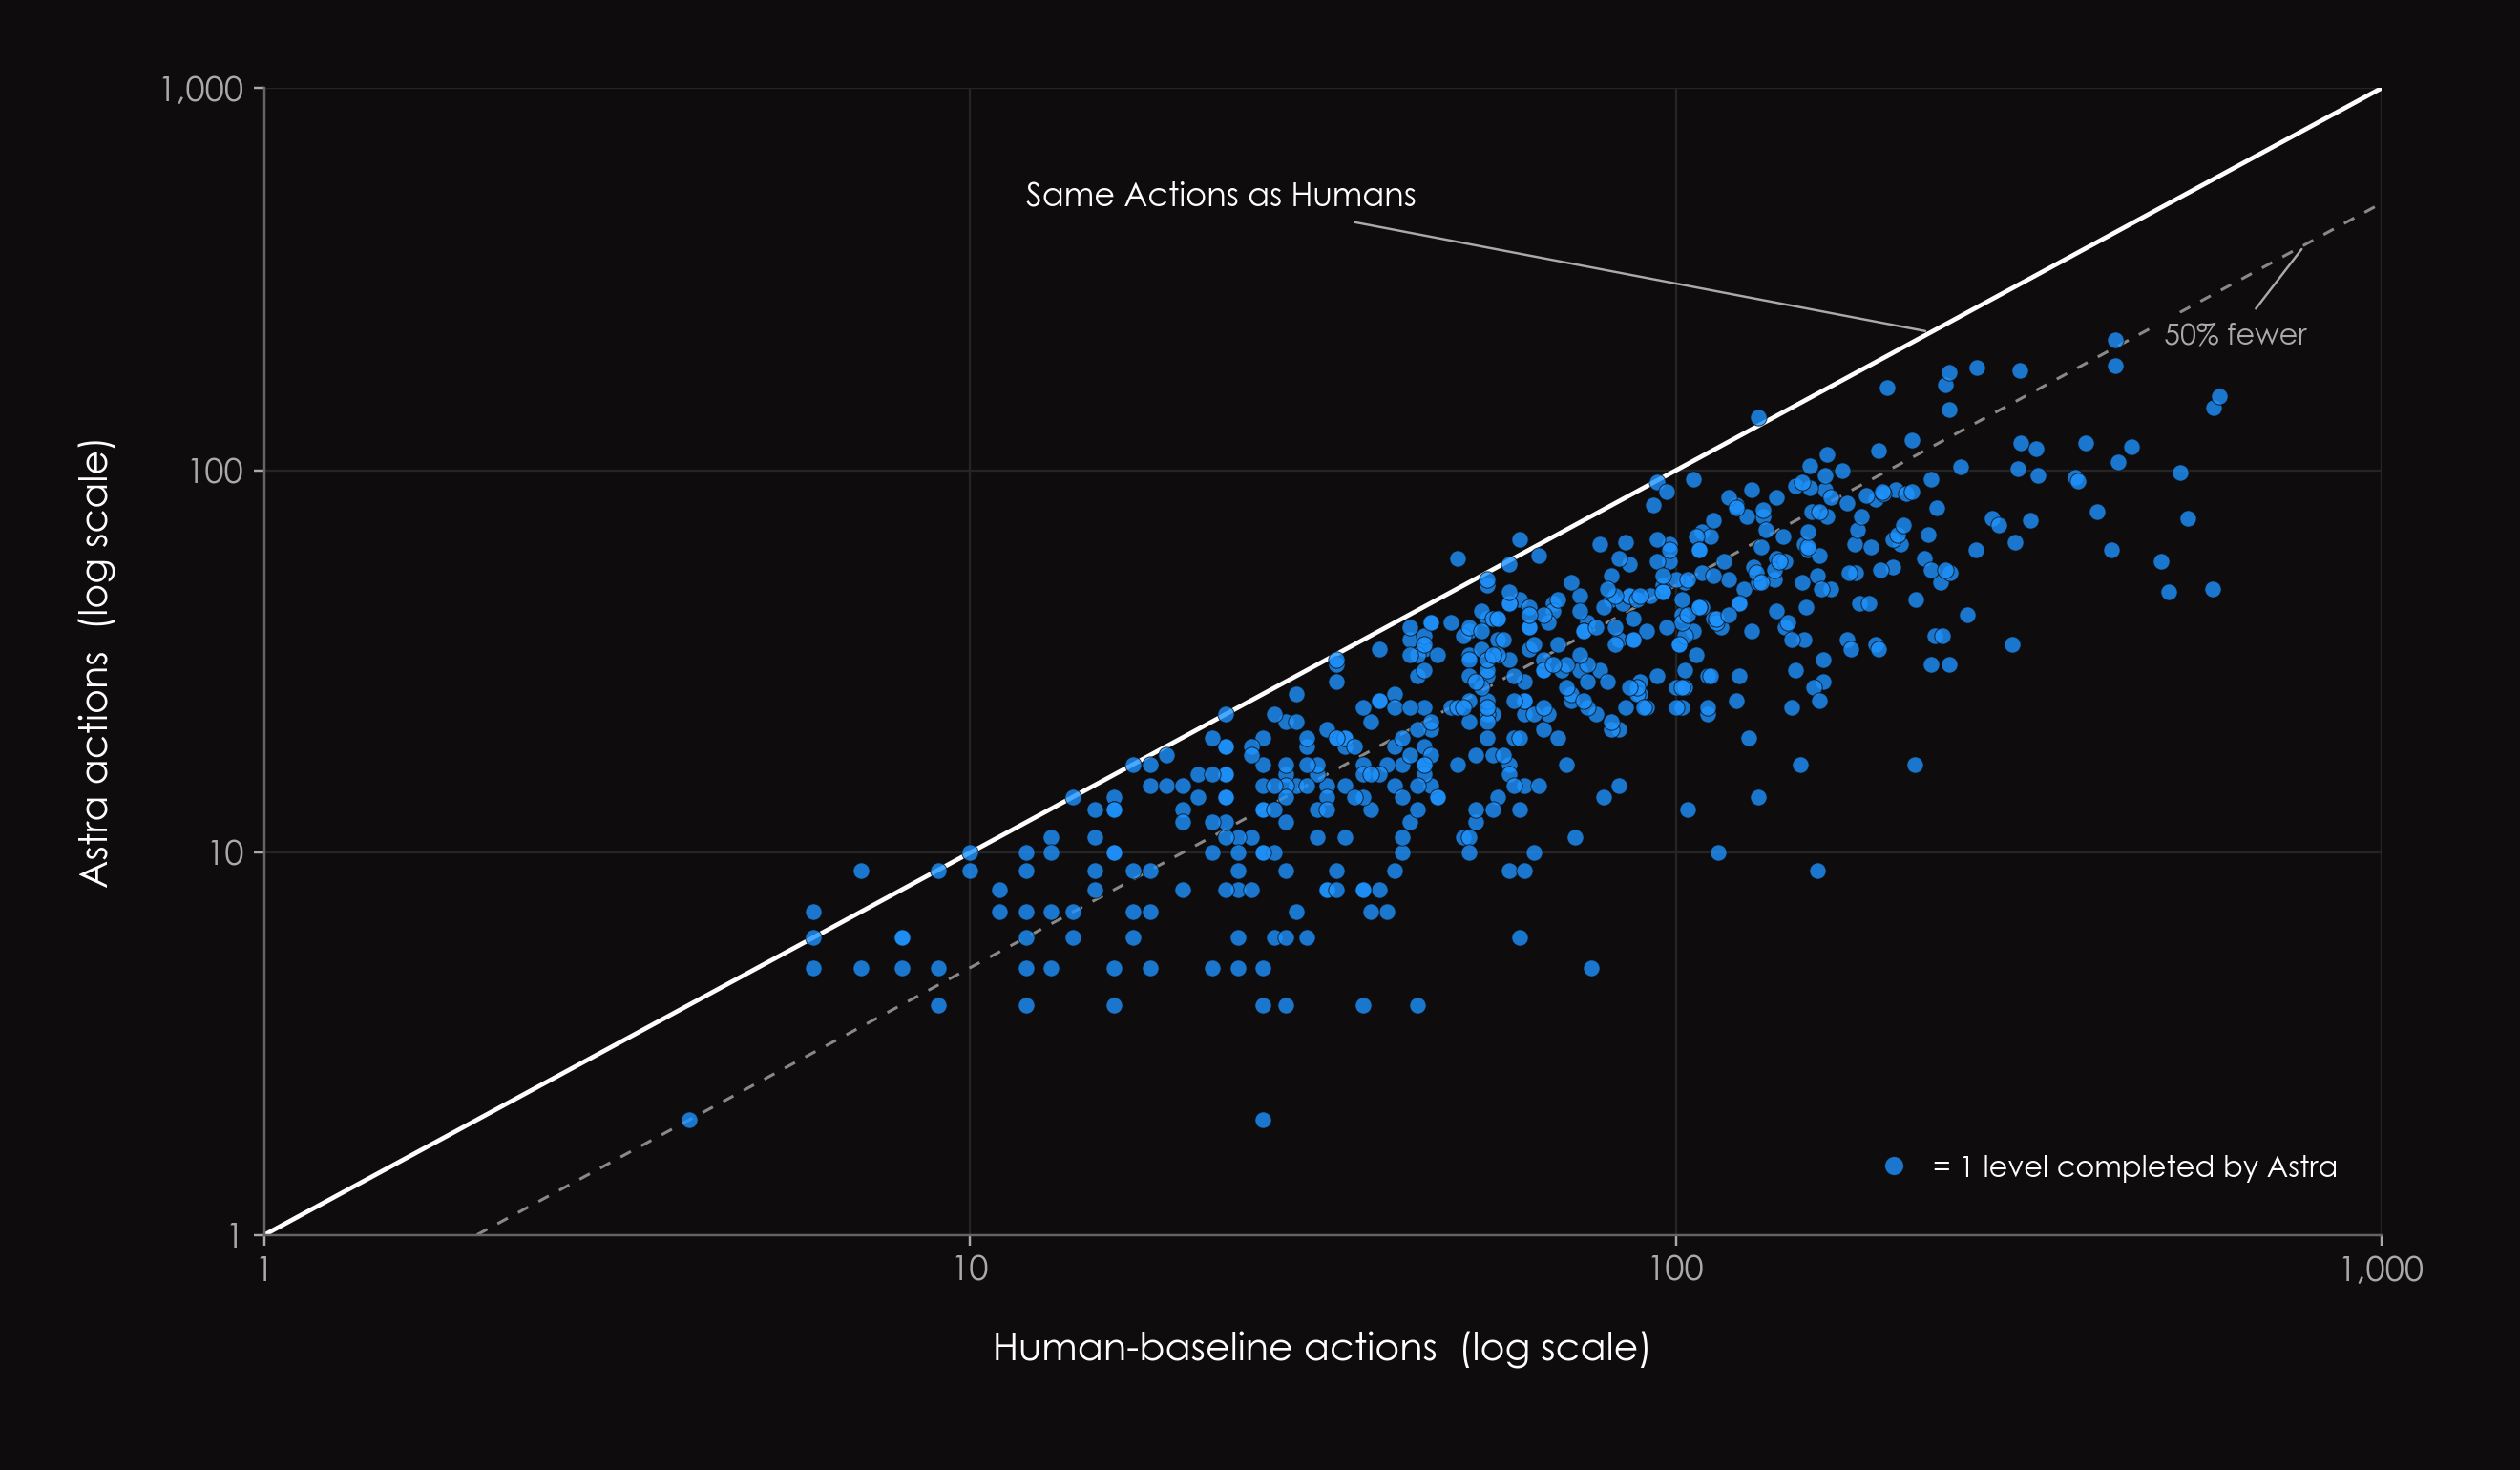
先看看它怎么闯关,再判断这个满分有多重
我们从两段公开案例入手,看看 AI 怎样试出规则、安排下一步,再拆开 99.9% 和“超过人类”。读完,你就有依据判断:这项突破证明了什么,还有什么没有证明。
系列上篇
《GPT-6 Astra 的“高考”成绩单(上):先看懂这七门考试》讲科学、数学、编程与专业工作的七项评测。
先把这张成绩榜摊开看看
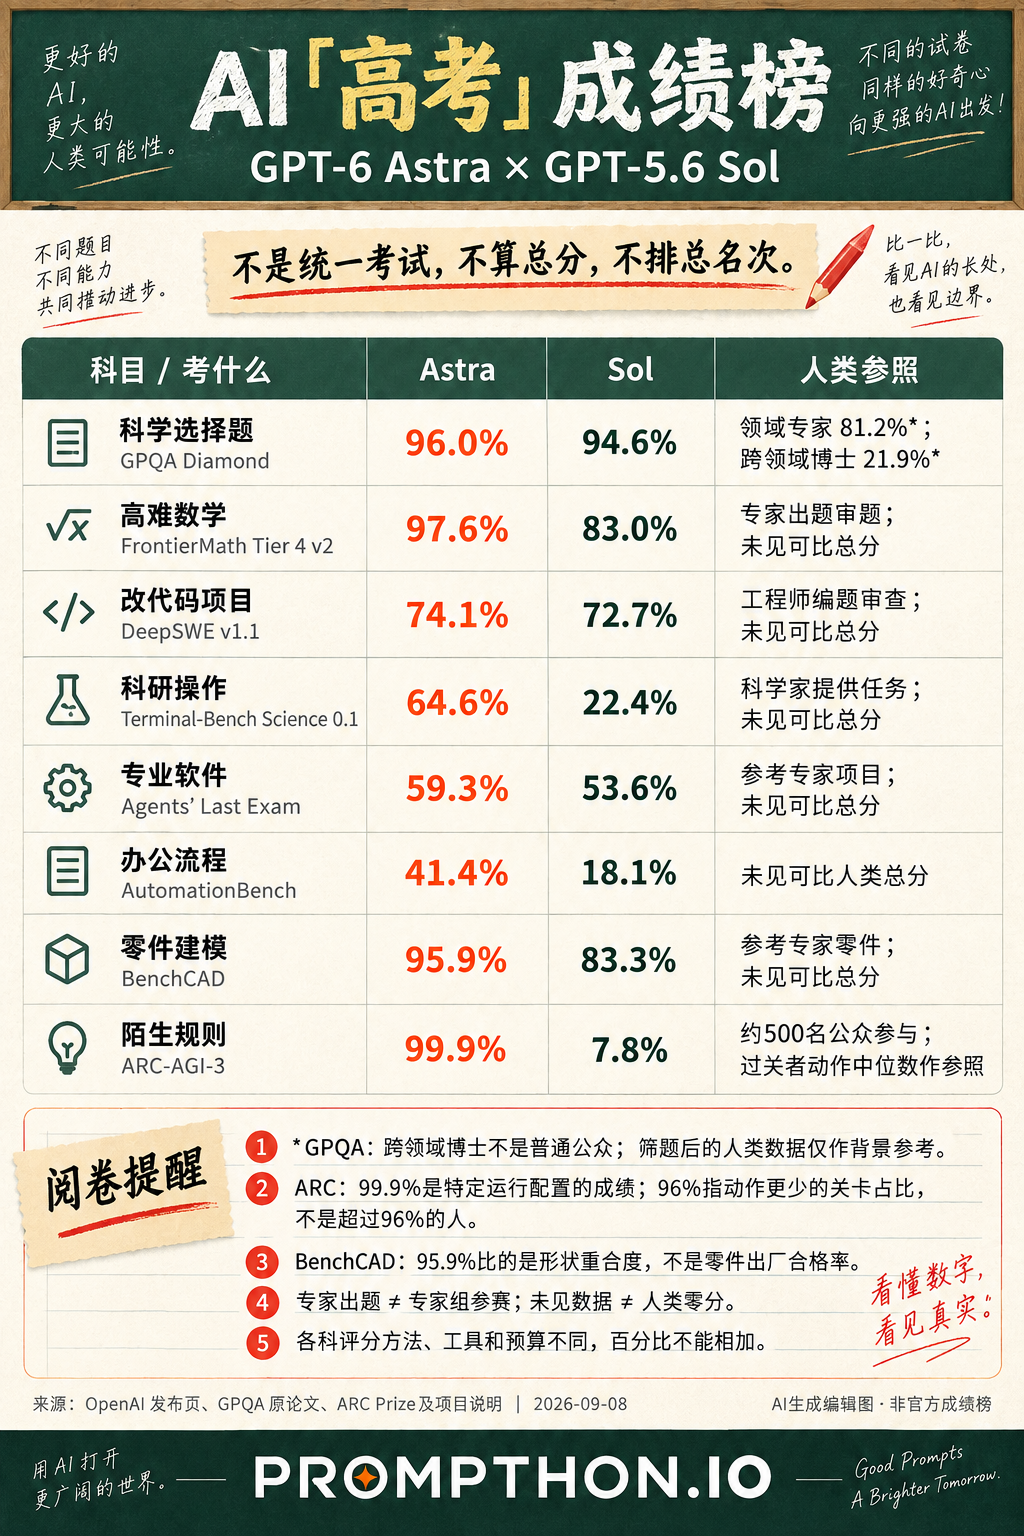
图:八项评测与人类参照一览,非官方榜单。各项百分比不能相加;人类栏是不同研究的参考,不是统一参赛排名。ARC 的 99.9% 与 96% 人类对比采用不同推理设置,见下文。
一个做深度学习的人,给 AI 出了道难题
这件事要从 2019 年说起。
François Chollet 提出了最早的 ARC。他也是 Keras 的创造者——很多人训练神经网络,用过的正是这套工具。他不是站在场外说“AI 不行”,而是想把一个不太好回答的问题,变成可以动手测试的东西。(评测起源,见参考资料 [3])
一个系统在熟悉的任务上很强,和它学新本领很快,是同一回事吗?
最早的 ARC 没有满屏公式,而是一格格彩色方块。给你几组变化前后的图,让你自己找出规律,再把规律用在新的图上。读者不必先成为数学博士,AI 却也未必占便宜:这里不是把百科全书背熟,就能直接找到答案。
2020 年,第一届相关比赛吸引了 913 支队伍,冠军在私有测试集上也只做对约 20%。到了 2024 年底,OpenAI 的 o3-preview 又让这套小方格题成了发布会上的焦点。它不是突然冒出来的一场考试,而是一道随着模型进步、不断往前追问的题。(比赛历史与项目介绍,见参考资料 [3]、[4])