O boletim do GPT-6 Astra, parte 1: O que sete avaliações realmente medem
Primeiro as tarefas, depois as notas: sete avaliações do Astra, exemplos cotidianos e os limites das comparações humanas.
Por Liqing Pan10 min de leitura
Traduzido de 简体中文
AI
Industry
Benchmarks
Crédito da imagem: Prompthon editorial artwork.
Em 3 de setembro de 2026, a OpenAI apresentou o GPT-6 Astra. Na apresentação à imprensa, Greg Brockman deu as boas-vindas à era da AGI, segundo a Fast Company.[1] O boletim incluía matemática avançada, programação e trabalho profissional.[2]
O destaque era 99,9% no ARC-AGI-3, que avalia a aprendizagem em ambientes interativos desconhecidos. O ARC Prize também relatou menos ações que a referência humana em 96% das fases, sob outra configuração.[3] Antes de interpretar essas notas, precisamos conhecer a prova.
Primeiro as tarefas, depois as notas. Este guia explica o que se pede, como se pontua e o que as comparações humanas significam. A primeira parte cobre sete avaliações; a segunda examina o ARC-AGI-3 e a discussão sobre inteligência geral.
1. GPQA Diamond: A internet não resolve tudo
Em novembro de 2023, David Rein e colegas apresentaram questões de biologia, física e química com quatro alternativas, projetadas para resistir ao atalho de procurar a resposta na internet.[5]
Os pesquisadores recrutaram especialistas e pessoas com formação avançada em outras áreas. Estas podiam pesquisar livremente e gastaram, em média, mais de meia hora por questão, mas acertaram apenas cerca de um terço na avaliação original. “Google-proof” significa que pesquisar não substitui o raciocínio especializado.
Exemplo criado para este artigo, não uma questão do GPQA: Um inibidor disputa com o substrato o mesmo local de ligação de uma enzima. Temperatura e acidez permanecem constantes. Acrescentar substrato reduz necessariamente a velocidade máxima, ou a reação ainda pode se aproximar da velocidade máxima original?
A segunda alternativa é correta nessas condições. Imagine dois grupos disputando os mesmos assentos: aumentar um dos grupos muda quem consegue sentar, sem destruir os lugares. O exemplo ilustra o raciocínio a partir das condições, não a dificuldade real do GPQA. Os autores pedem que as questões não sejam republicadas na internet.[4]
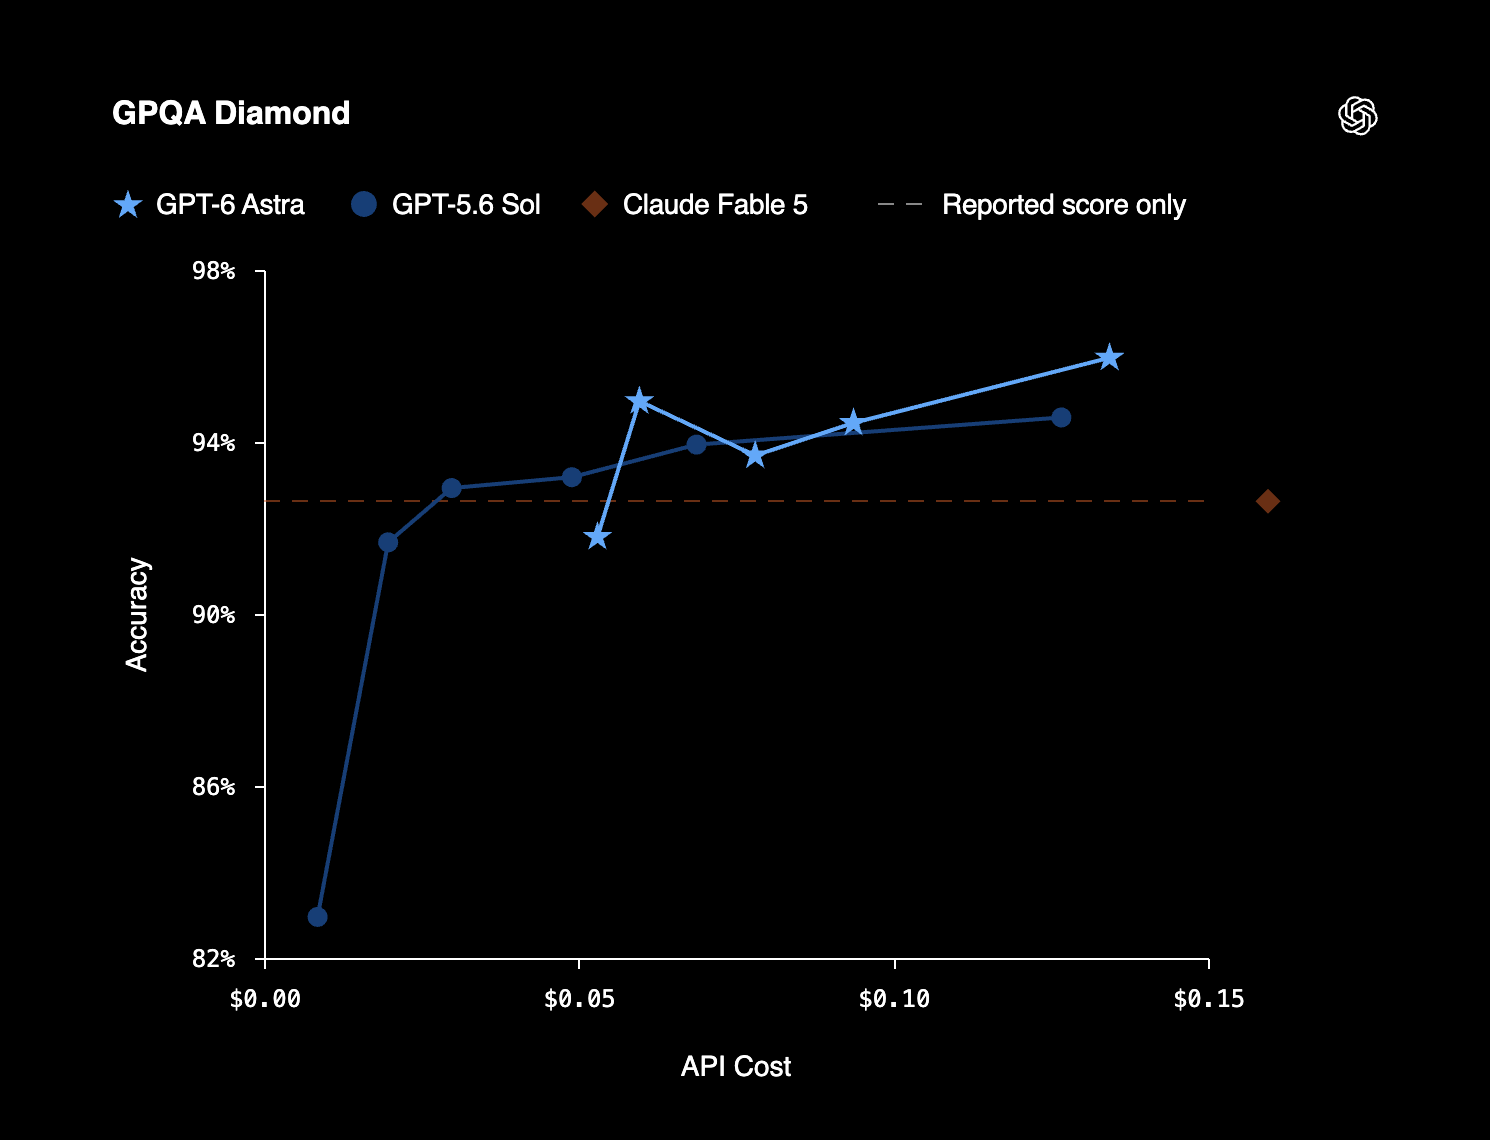
Crédito da imagem: OpenAI — GPT-6 Astra release; official evaluation chart.
OpenAI: Astra 96,0%; GPT-5.6 Sol 94,6%. Os diferentes pontos refletem configurações de avaliação. A seção 5 explica o eixo de custo.
O Diamond reúne 198 questões selecionadas. A tabela 5 do artigo original informa 81,2% para especialistas da área e 21,9% para participantes de outras áreas, que eram doutores ou doutorandos, não uma amostra aleatória da população. A seleção favoreceu perguntas que especialistas acertavam e pessoas de fora tinham dificuldade em responder. Portanto, essas notas não representam uma nova disputa entre humanos e IA nas mesmas condições; dois especialistas revisando separadamente também não formam uma equipe competidora.[4]
O Astra melhora de 94,6% para 96,0%. Isso demonstra desempenho em questões especializadas, mas não informa se o modelo consegue montar e executar um experimento no laboratório.
2. FrontierMath: Matemáticos preparam novas provas
Com o avanço da IA nos testes antigos, a Epoch AI encomendou problemas inéditos. Elliot Glazer e colegas apresentaram o FrontierMath em novembro de 2024. Alguns problemas exigem horas ou dias de especialistas. A retrospectiva da Epoch registra a participação de três medalhistas Fields e de um especialista na Olimpíada Internacional de Matemática na avaliação da dificuldade.[7][8]
O modelo pode calcular e tentar caminhos diferentes, mas precisa entregar uma resposta verificável.
Exemplo público do apêndice A.5 do artigo de 2024, não do Tier 4 v2: Em um corpo finito com 5¹⁸ elementos, quantas soluções não nulas satisfazem x³y + y³z + z³x = 0, considerando iguais as que diferem apenas por um fator de escala comum não nulo?[17]
Um corpo finito é um conjunto finito de valores com regras aritméticas definidas. É preciso contar e eliminar repetições. Pense em contar desenhos diferentes sem considerar uma simples mudança de escala como um desenho novo: encontrar candidatos não basta, é preciso reconhecer equivalências. A comparação explica a contagem, não a aritmética do corpo. Esse exemplo antigo era relativamente fácil e não identifica as questões responsáveis pela nota atual.
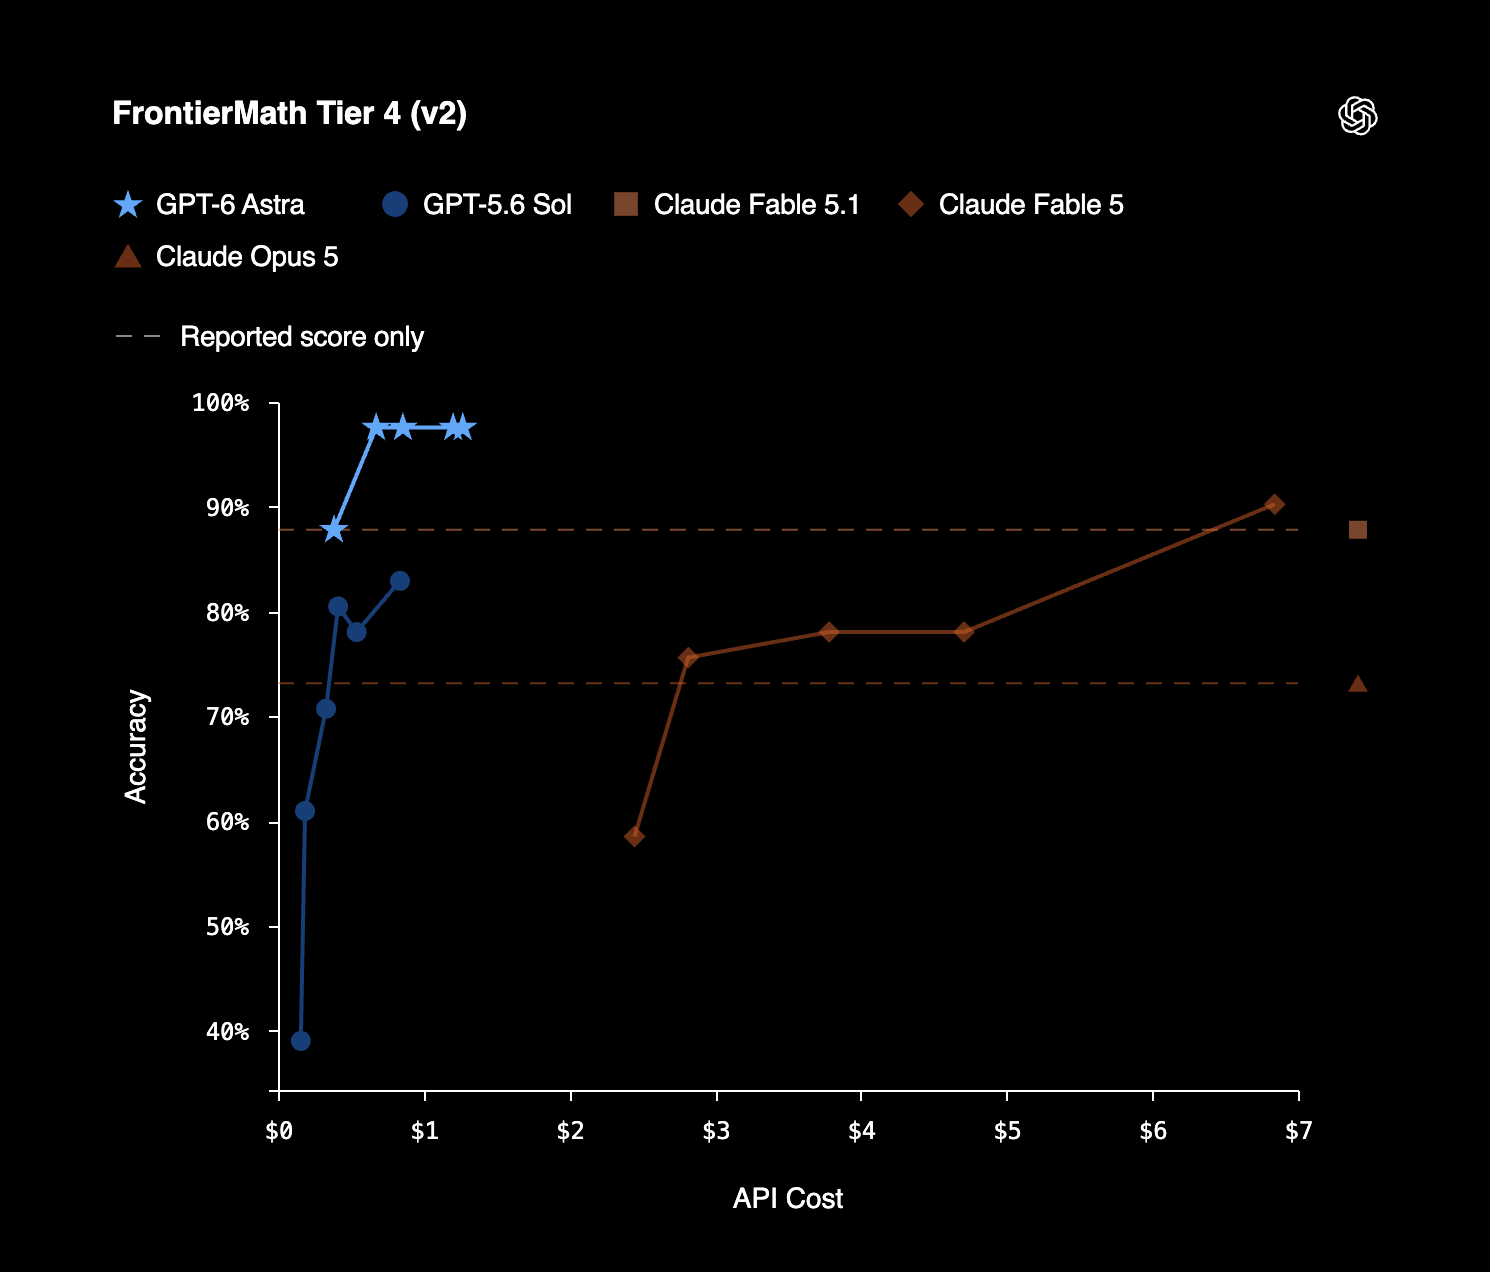
Crédito da imagem: OpenAI — GPT-6 Astra release; official evaluation chart.
OpenAI: FrontierMath Tier 4 v2, Astra 97,6%; Sol 83,0%.
A evolução é expressiva. A versão importa: a Epoch corrigiu problemas em junho de 2026, e notas de versões diferentes não são automaticamente comparáveis.[6]
Matemáticos criaram e verificaram as tarefas. A documentação consultada para a edição chinesa não trouxe notas agregadas comparáveis do público, de especialistas ou de equipes. “Um especialista pode levar dias” informa dificuldade, não uma classificação em prova cronometrada. Tampouco 97,6% significa resolver essa parcela de todos os problemas matemáticos ainda abertos.
3. DeepSWE: Consegue corrigir sem conhecer a solução?
Repositórios públicos oferecem tarefas reais, mas também expõem discussões e correções concluídas. Se o treinamento incluiu esse material, parte da nota pode refletir contato anterior com a solução.
Wenqi Huang e colegas apresentaram o DeepSWE em julho de 2026 para enfrentar esse problema. Criaram 113 tarefas em projetos reais, com verificadores separados. A solução funcional não precisa reproduzir o código de referência linha por linha.[9][10]
Paráfrase de tarefa pública: Corrigir a limpeza de recursos no Happy DOM, que simula um navegador. Ao fechar ou mudar de página, interromper adequadamente requisições e respostas inacabadas, preservar conteúdo já lido e remover temporizadores que não devem continuar.[9]
Fechar uma aba parece uma ação só, mas vários trabalhos continuam internamente. É como fechar uma loja: cancelar entregas pendentes quando necessário, preservar recibos e desligar equipamentos sem destruir trabalho concluído. O modelo precisa localizar essas responsabilidades no código e evitar regressões.
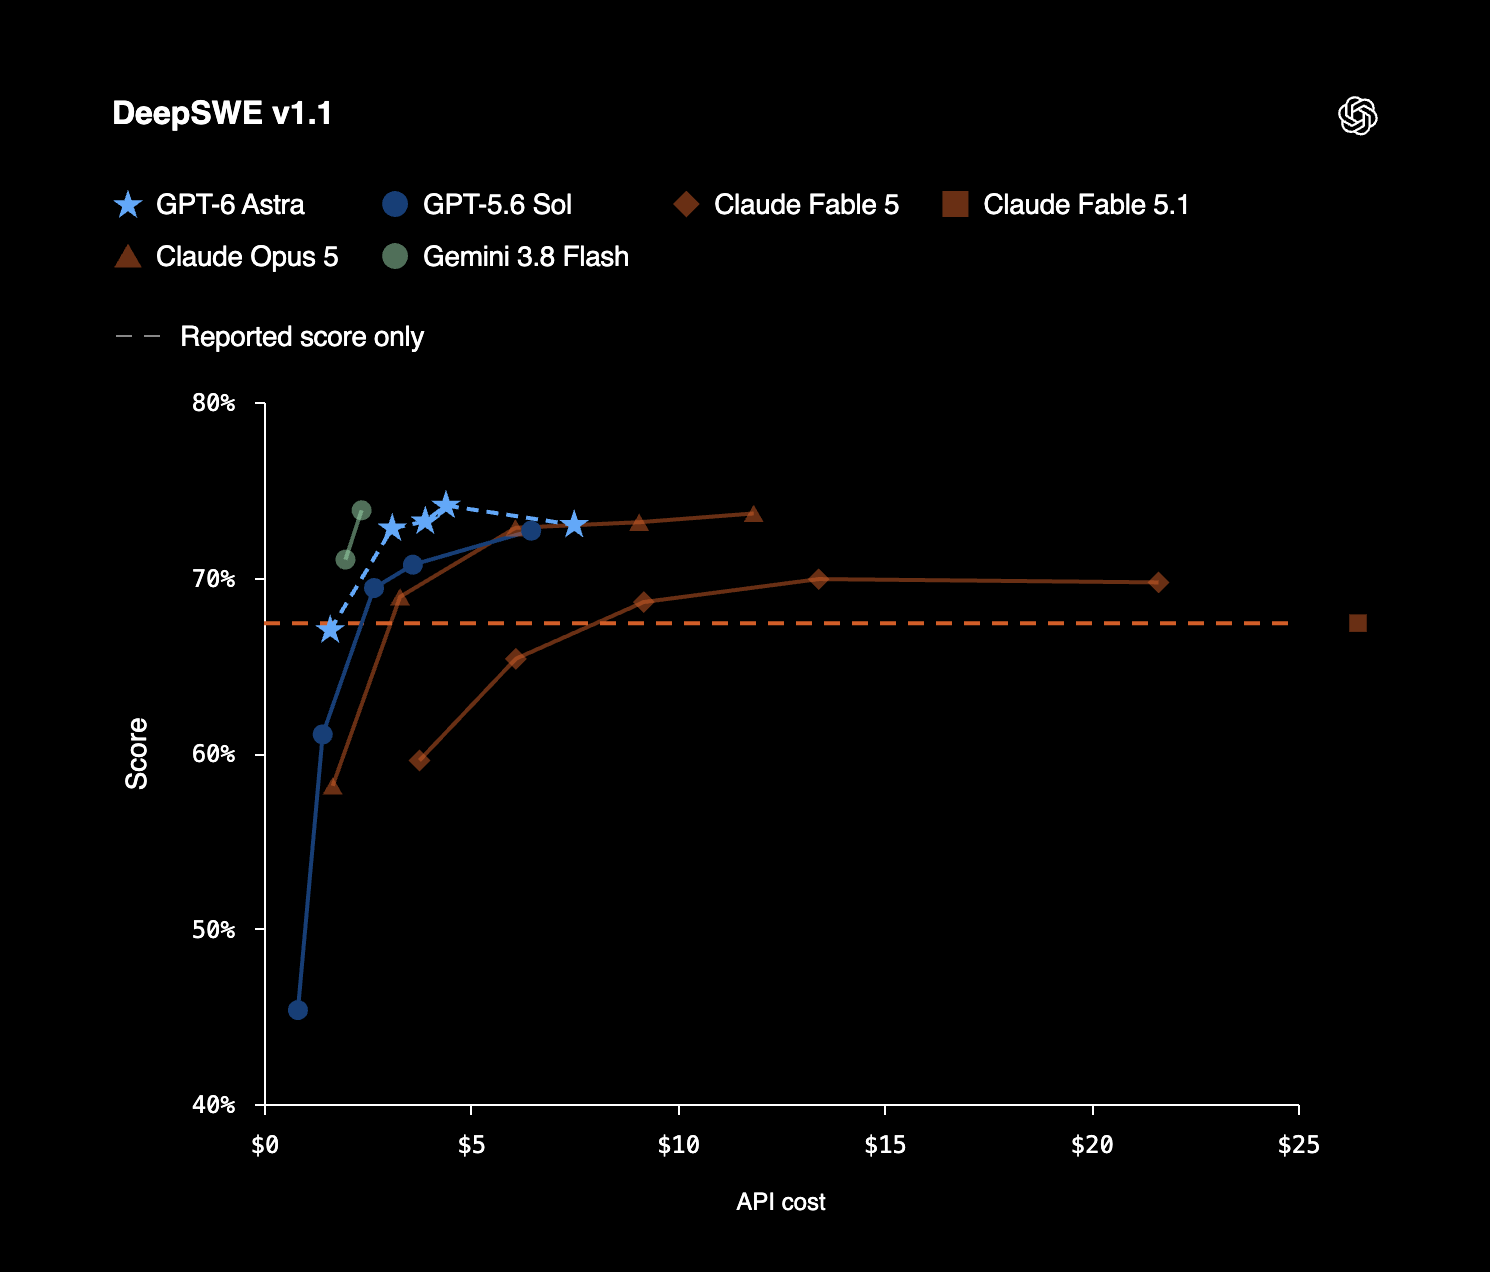
Crédito da imagem: OpenAI — GPT-6 Astra release; official evaluation chart.
OpenAI: DeepSWE v1.1, Astra 74,1%; Sol 72,7%.
O ganho é menor que em matemática. Engenheiros forneceram soluções e testes, não notas humanas obtidas sob o mesmo limite de tempo. O artigo também não estimou o tempo efetivo de conclusão por humanos. A avaliação mede trabalho útil, mas não determina quantos programadores o Astra supera.[9]
4. Terminal-Bench Science: O trabalho de pesquisa ficou pronto?
Uma explicação clara não elimina dados por processar ou uma simulação quebrada. O Terminal-Bench Science, liderado por pesquisadores de Stanford com a equipe Terminal-Bench e cientistas, parte desses problemas reais.
A seleção inicial aceitou 70 tarefas entre 920 propostas. Além de difíceis, precisavam ser relevantes para a pesquisa e ter resultados verificáveis.[11]
Exemplo do repositório público atual: Corrigir a transferência de dados atmosféricos ou oceânicos entre malhas esféricas, respeitando regiões mascaradas, conservação e limites de valores.[18]
Imagine dois mapas que dividem a mesma região do oceano em células diferentes. Transferir medições exige mais que suavizar o segundo mapa: a conversão não pode criar ou perder a quantidade acompanhada. Regiões ausentes e fronteiras curvas tornam a média simples insuficiente. O exemplo ilustra o trabalho, sem ser identificado aqui como item pontuado da versão 0.1.
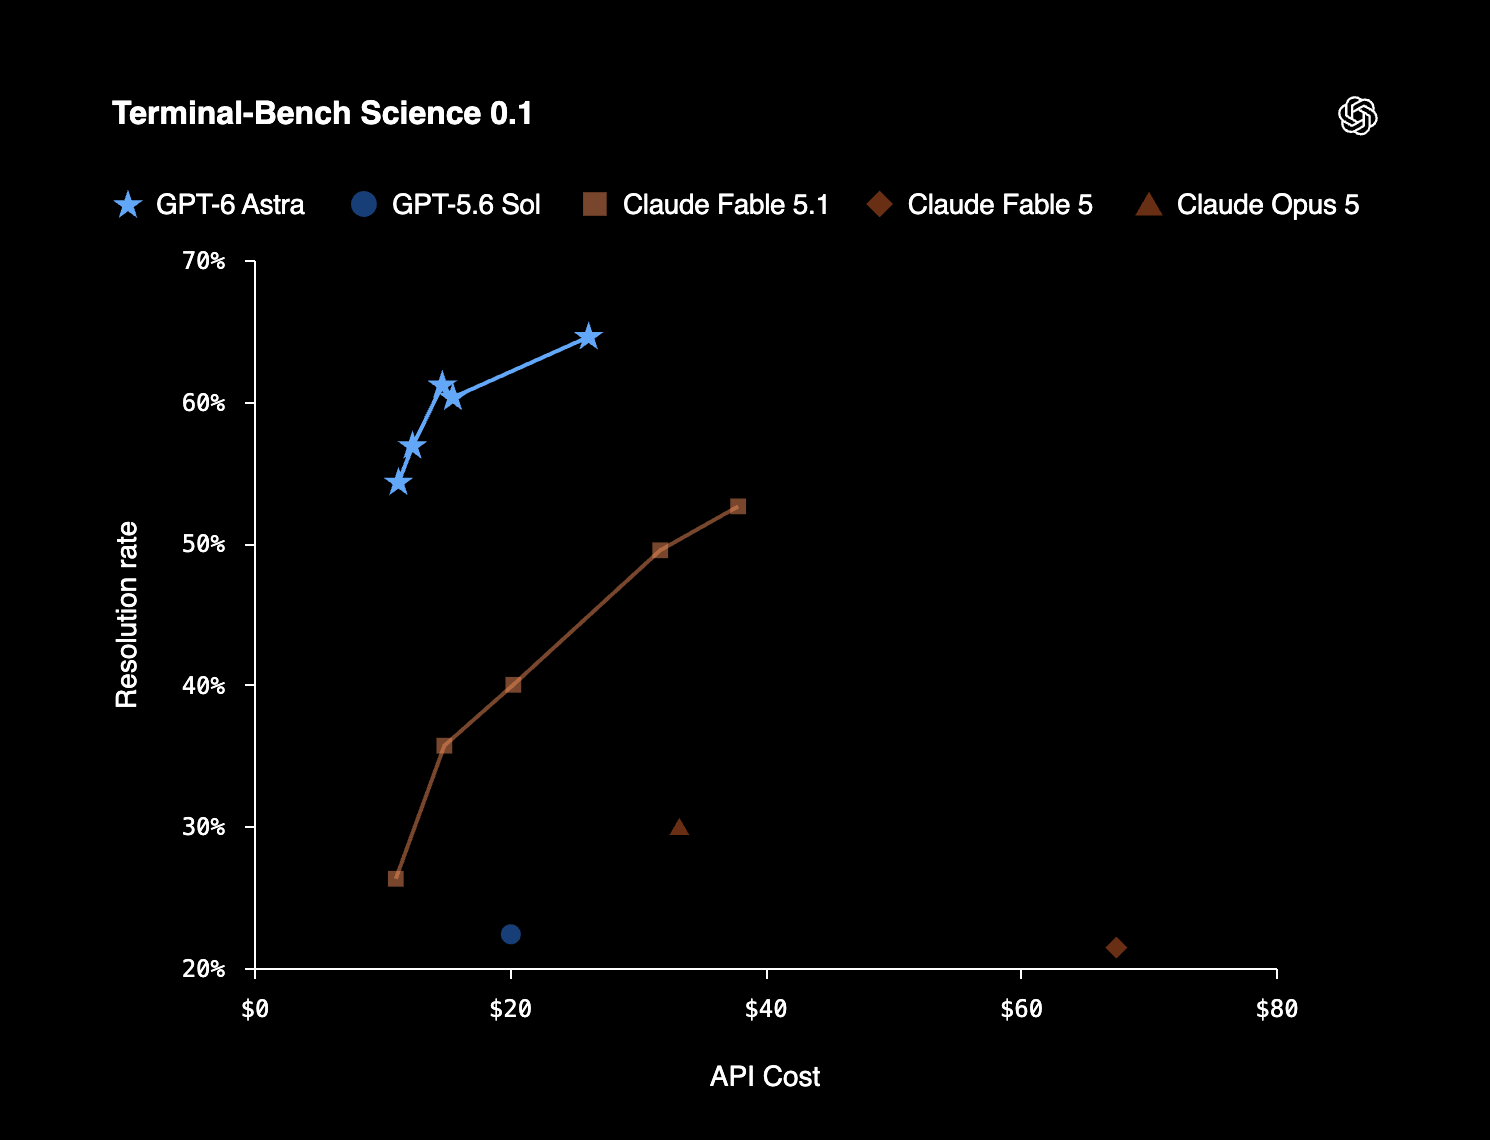
Crédito da imagem: OpenAI — GPT-6 Astra release; official evaluation chart.
OpenAI: Terminal-Bench Science 0.1, Astra 64,6%; Sol 22,4%.
Mais tarefas específicas foram concluídas. As notas são da avaliação da OpenAI, não de uma repetição nossa. Cientistas ajudaram a definir e verificar os trabalhos, mas o relatório inicial não publicou uma prova humana comparável entre áreas. Executar uma tarefa atribuída também não equivale a escolher autonomamente uma boa pergunta científica.
5. Agents’ Last Exam: O programa está aberto; faça o trabalho
Apresentado em junho de 2026 por Yiyou Sun e colegas, com liderança do Berkeley RDI e da RDI Foundation, o Agents’ Last Exam pede trabalho dentro de programas profissionais.[12][13][14]
Exemplo de desenho de tarefa no artigo: Inserir um guepardo correndo, extraído de um vídeo, em outro vídeo de competição.[12]
Quem já tentou trocar um fundo de vídeo conhece o problema: um recorte estático não basta. O animal e a câmera se movem, a postura muda, e a integração precisa manter movimento e aparência coerentes. O exemplo mostra a escala desejada, não uma execução específica que tenha gerado a nota publicada.
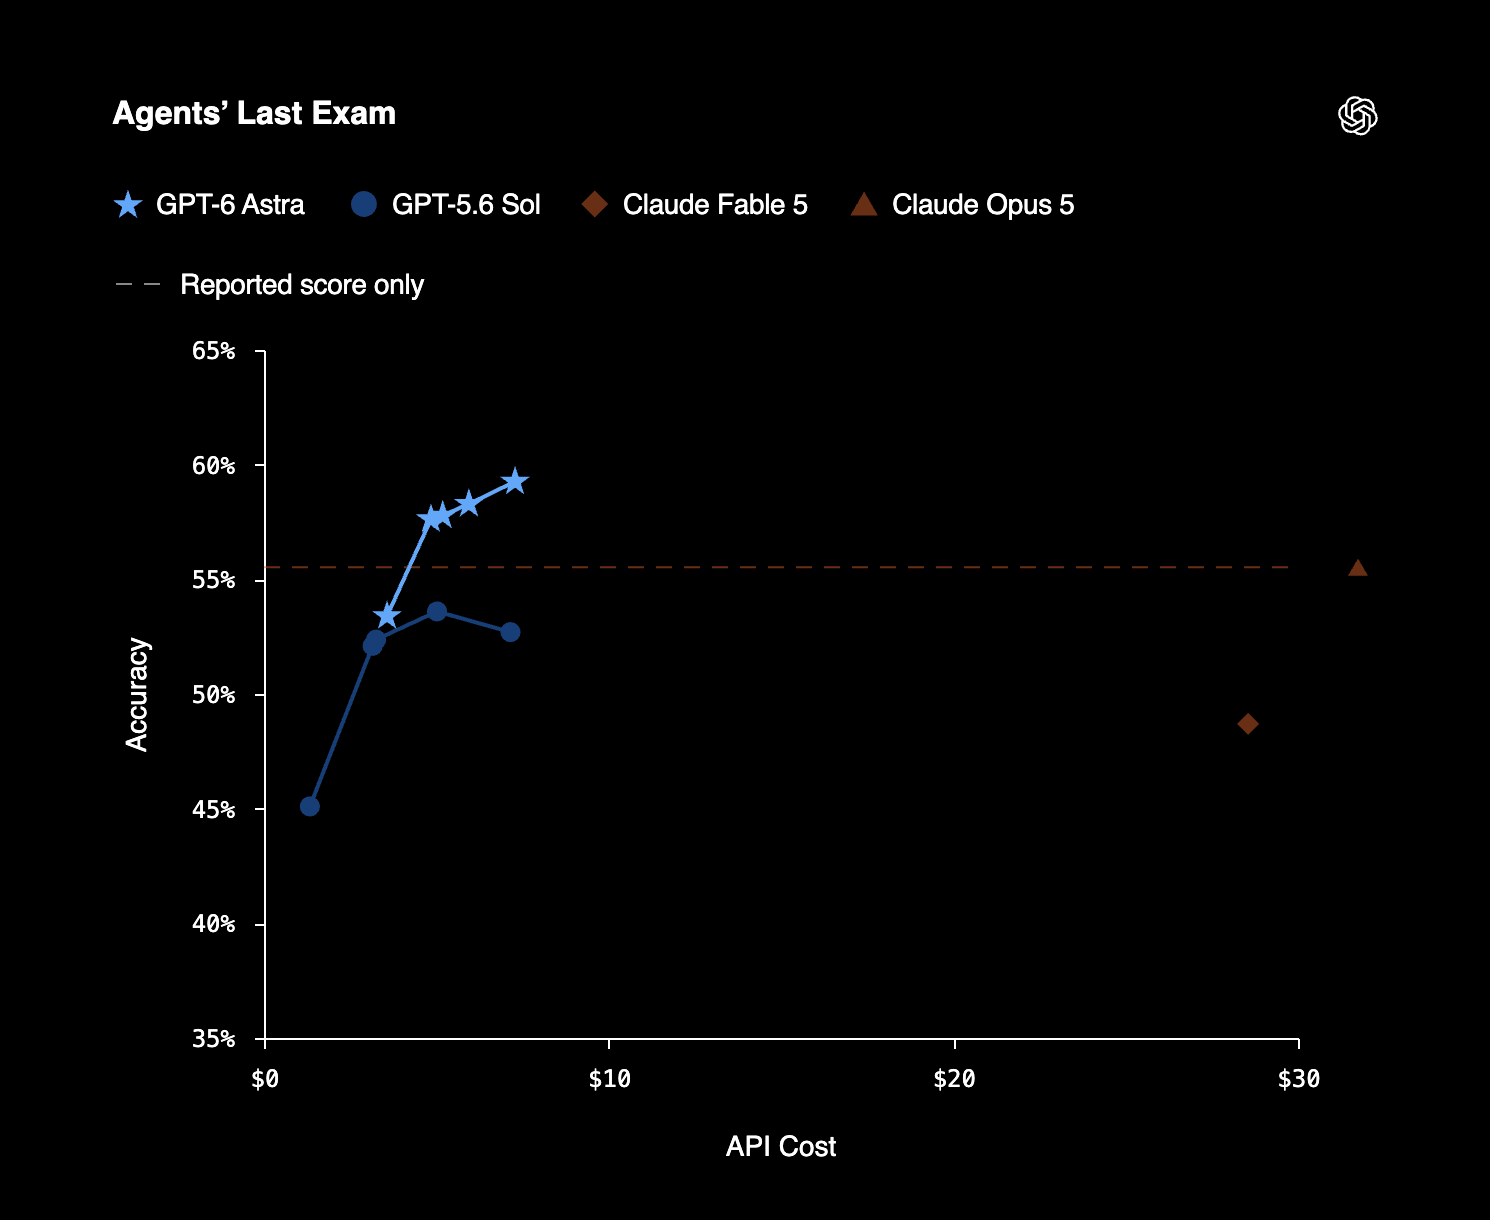
Crédito da imagem: OpenAI — GPT-6 Astra release; official evaluation chart.
OpenAI: Agents’ Last Exam, Astra 59,3%; Sol 53,6%. Observe também o custo.
Nos gráficos oficiais, o eixo horizontal indica custo de API e o vertical, nota. Vários pontos do mesmo modelo representam configurações avaliadas. A OpenAI informa que a tabela-resumo usa a melhor nota entre níveis de esforço de raciocínio.[2] O texto não explica por que alguns outros modelos têm apenas um ponto; isso não prova que só tenham uma configuração.
Resultados profissionais de referência e comitês de especialistas estabelecem critérios, mas não representam uma equipe humana disputando a prova. As fontes consultadas não ofereceram notas humanas agregadas comparáveis. E 59,3% não é a parcela das profissões que pode ser entregue à IA: a nota se refere às tarefas e aos arquivos produzidos.
6. AutomationBench: A mensagem certa para a pessoa errada falha
Atualizar um cadastro, mudar um compromisso e avisar um colega parecem tarefas simples. Também permitem erros quase imperceptíveis: o valor correto no cliente errado pode causar um problema sério.
O AutomationBench, da Zapier, usa ferramentas empresariais simuladas e verifica o estado final. Todos os requisitos precisam passar para a tarefa contar como concluída.[15]
Exemplo público simplificado: Duas reuniões se sobrepõem no Zoom e no Google Calendar. Consulte as prioridades em uma planilha, acrescente [RESCHEDULED] ao título da reunião correta e explique o resultado no canal Slack indicado, com os dois identificadores.[19]
A dificuldade é decidir qual reunião alterar. Um parceiro externo afirma ter prioridade, mas seu e-mail não pode substituir as regras internas. Nomes parecidos podem apontar para outros registros. Neste exemplo, o requisito de reagendamento é uma marca no título, não encontrar outro horário. A IA deve cumprir o pedido real.
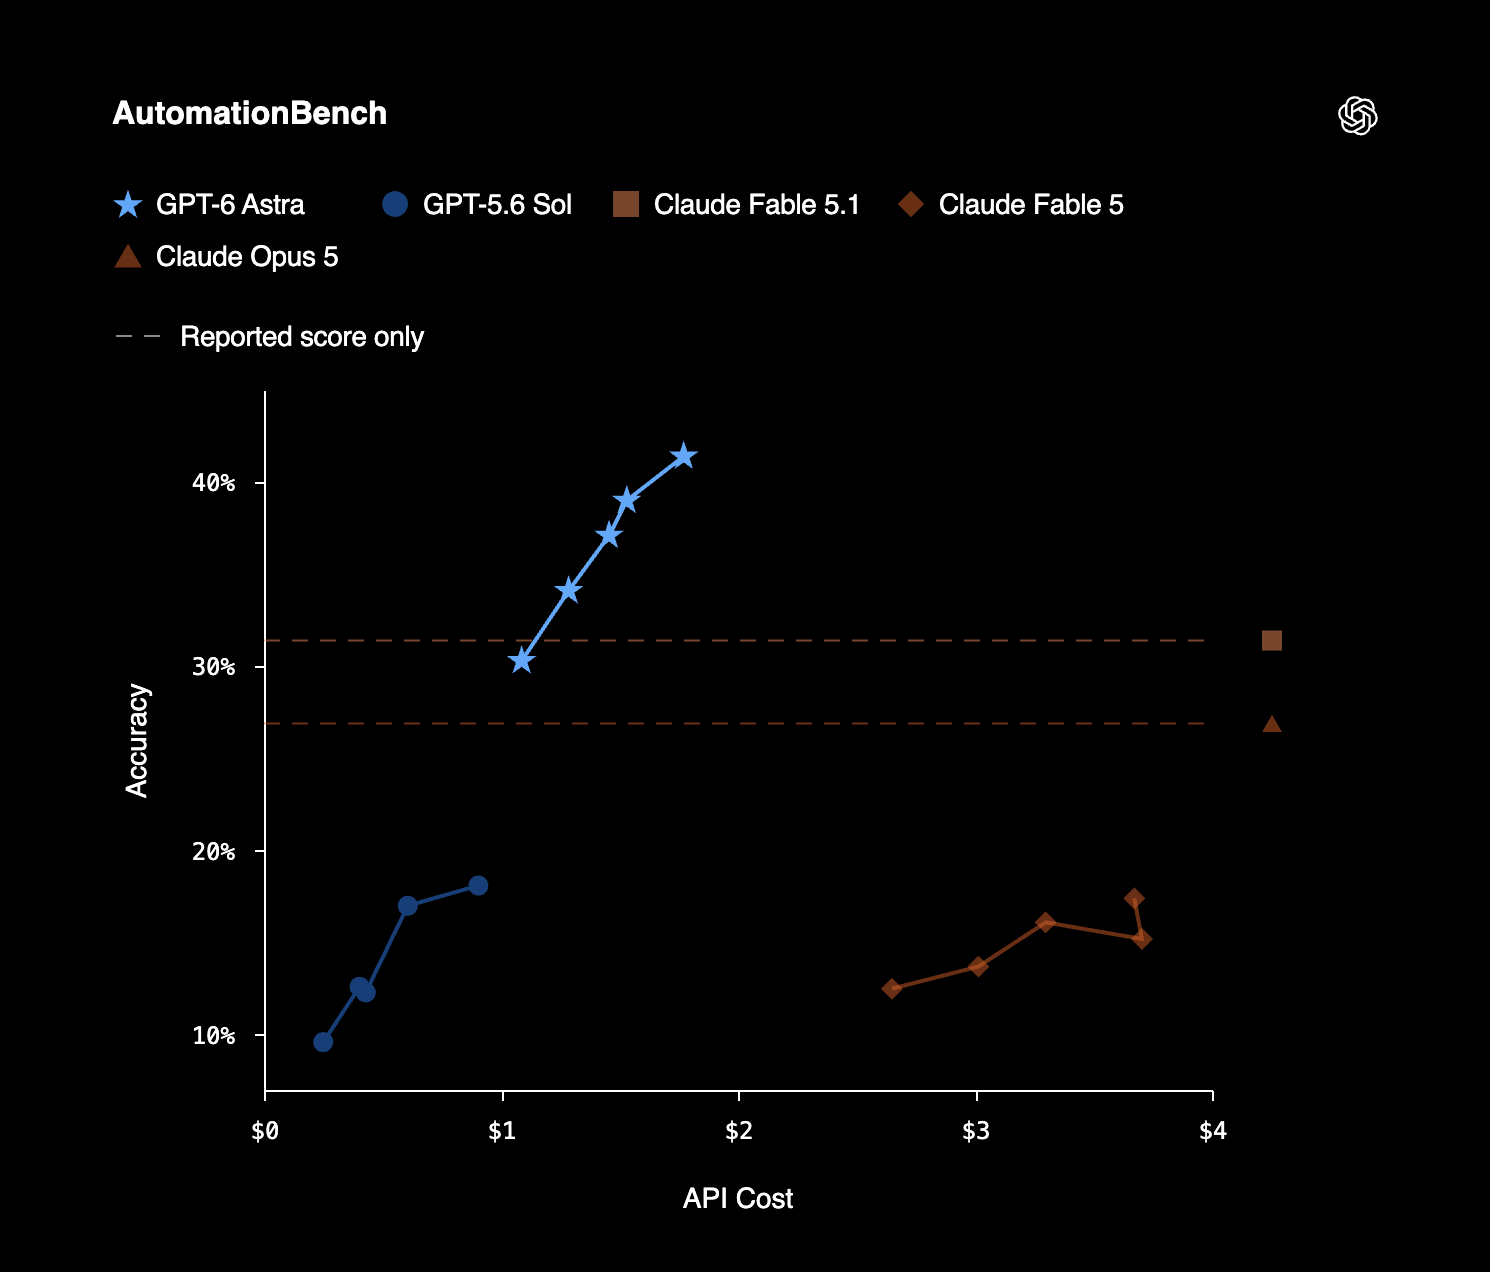
Crédito da imagem: OpenAI — GPT-6 Astra release; official evaluation chart.
OpenAI: AutomationBench, Astra 41,4%; Sol 18,1%.
Houve grande avanço, mas muitas tarefas continuam incompletas. O lançamento usa um conjunto privado mais difícil, não a classificação de exercícios públicos. As fontes consultadas para a edição chinesa não ofereceram notas comparáveis de trabalhadores ou equipes humanas. A familiaridade da tarefa não justifica atribuir nota máxima às pessoas.
7. BenchCAD: Parece certo, mas o parafuso passa?
Uma peça pode parecer convincente e falhar por um furo deslocado ou uma parede espessa. O BenchCAD pede a reconstrução de peças a partir de várias vistas usando código, com exemplos industriais que incluem referências a padrões reais.[16]
Exemplo público de edição: Abrir um furo cilíndrico de raio 20 mm em uma tampa de motor, atravessando o disco inferior e a parte elevada. É o caso 167 do BenchCAD-Edit, usado para ilustrar um erro espacial, não o item de reconstrução por trás da nota.[20]
O artigo mostra falhas em que o furo é aberto e depois uma parte sólida volta a fechar sua seção superior. De um ângulo, parece pronto; por dentro, continua bloqueado. Tentar passar um parafuso revela o erro imediatamente.
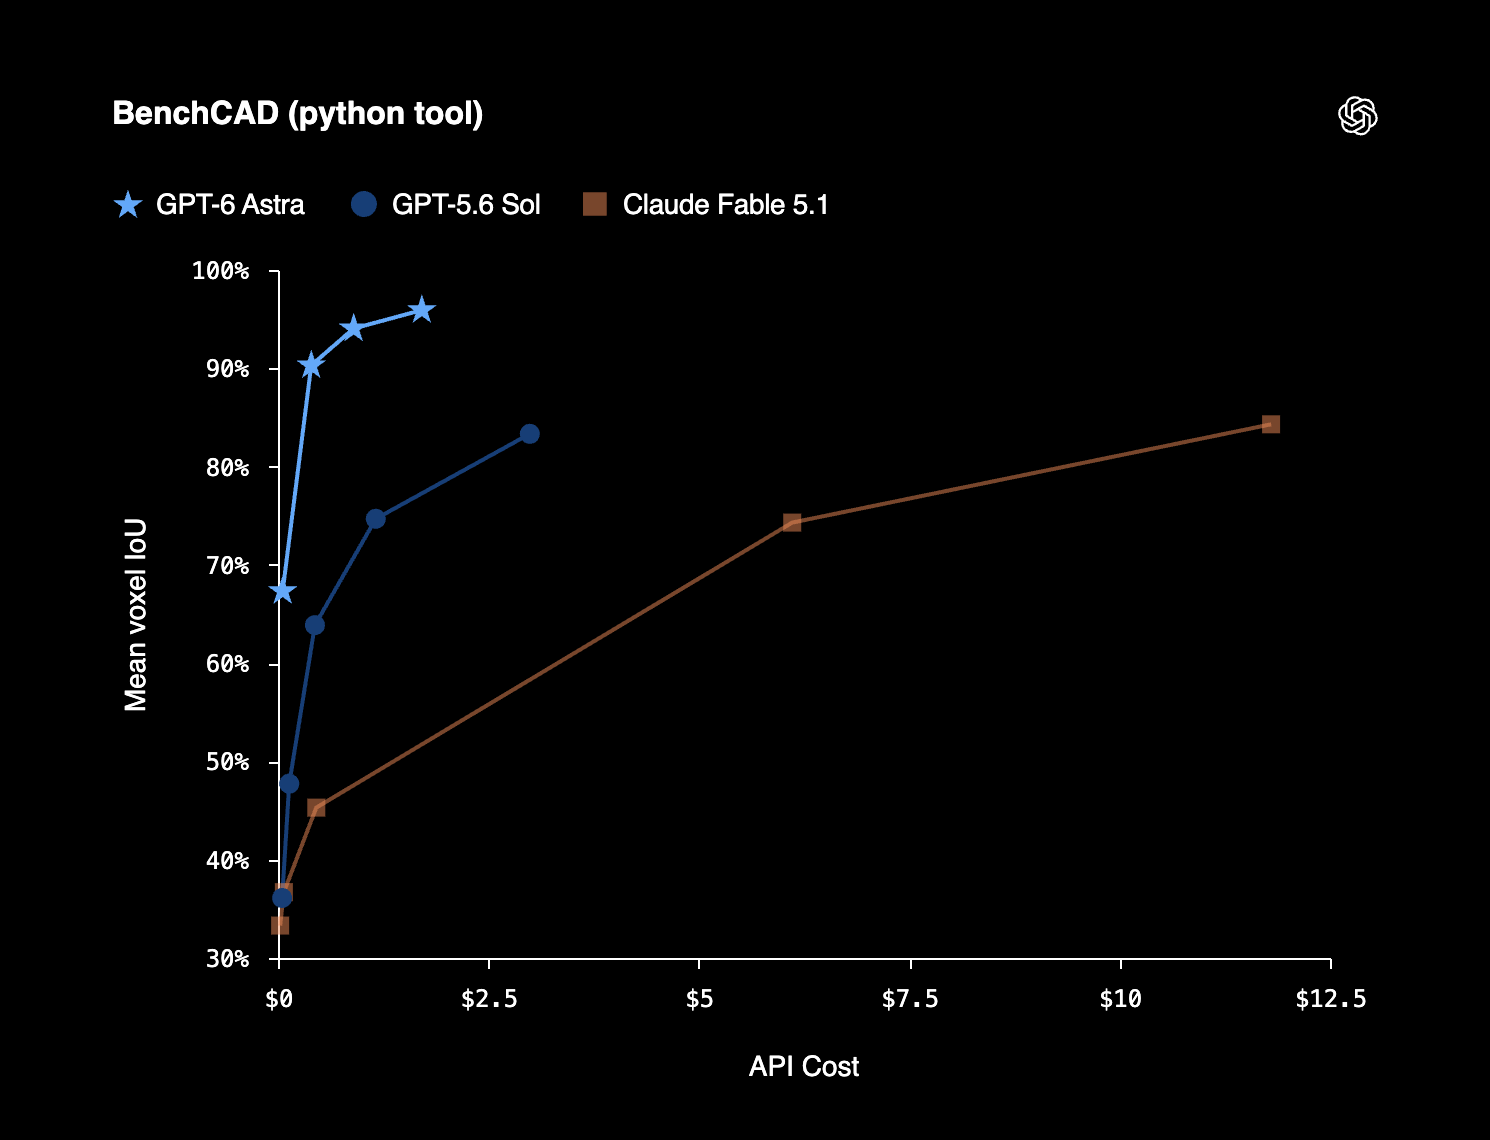
Crédito da imagem: OpenAI — GPT-6 Astra release; official evaluation chart.
OpenAI: BenchCAD com ferramenta Python, Astra 95,9%; Sol 83,3%. A métrica mede sobreposição de formas, não prontidão industrial.
Acertar a geometria é relevante. Resistência, fabricação e montagem ainda exigem verificações próprias. A nota não significa que 95,9% das peças possam entrar diretamente em produção.
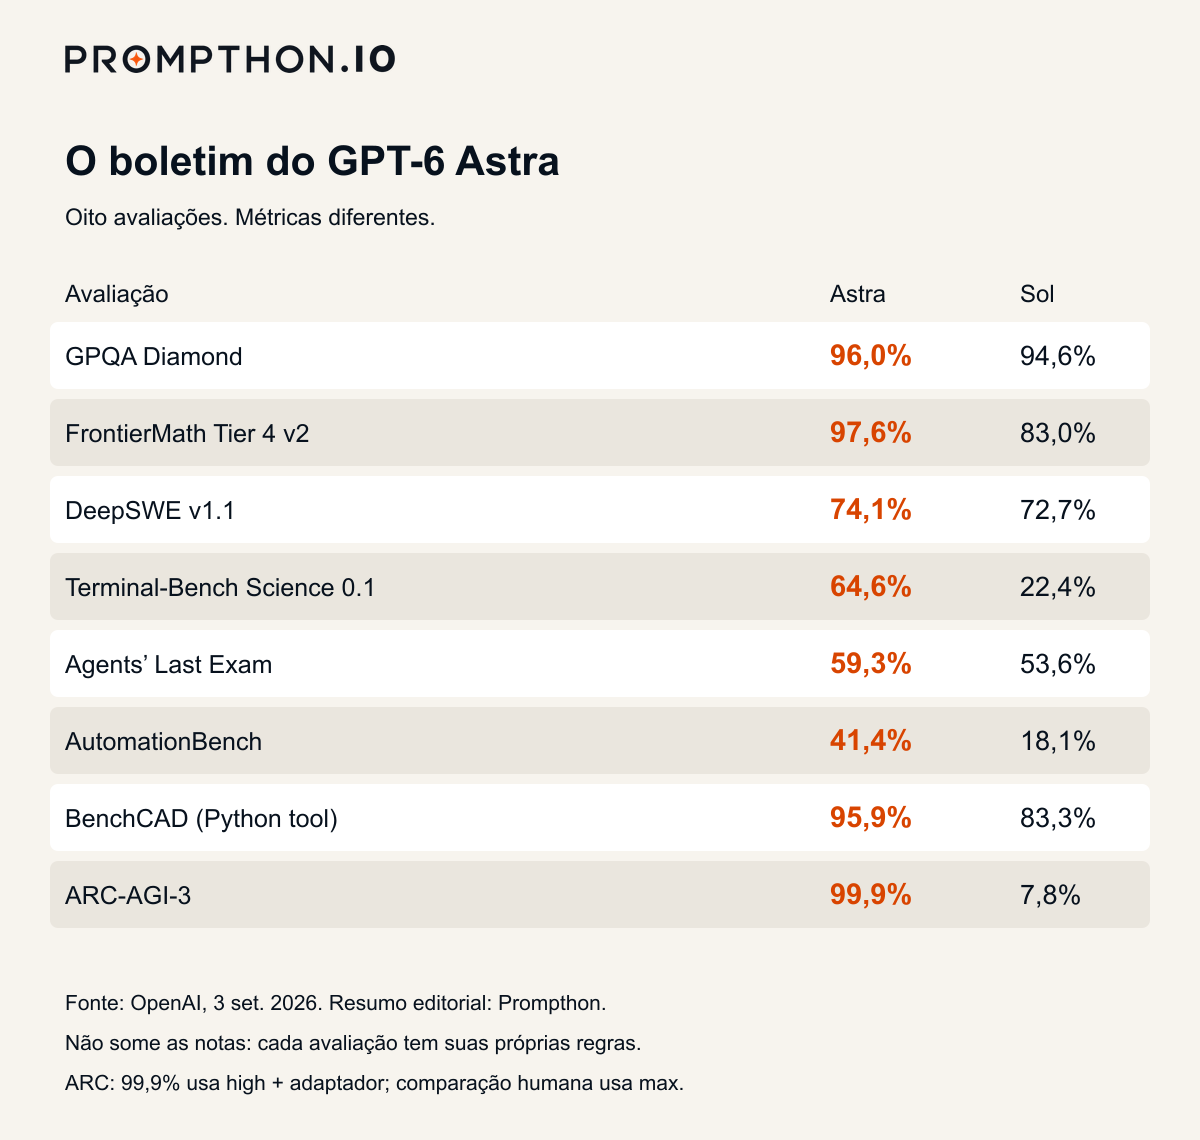
O boletim em contexto
Crédito da imagem: Prompthon editorial artwork.
Resumo editorial da Prompthon. As porcentagens têm regras diferentes e não podem ser somadas. Referências humanas vêm de estudos distintos; as configurações do ARC são explicadas na parte 2.
As sete provas mostram avanços diferentes: responder, corrigir, processar e produzir. Os ganhos são desiguais, o que informa mais que uma declaração genérica de superioridade.
Falta o 99,9%. A pergunta seguinte é se um sistema aprende a agir em um ambiente desconhecido, sem manual. A parte 2 acompanha dois exemplos públicos e examina a referência humana e o programa de avaliação.
Adaptado da edição chinesa publicada em 8 de setembro de 2026. As notas correspondem a versões e configurações específicas. Exemplos e demonstrações oficiais não são experimentos da Prompthon. A numeração das fontes mantém a edição original.