想法、实践与观察
博客 关于 AI 的思考与实践,记录与 AI 一起创造的人,以及正在改变我们工作方式的新变化。
GPT-6 Astra 的“高考”成绩单(上):先看懂这七门考试 | Prompthon
← 全部文章观点与实践
GPT-6 Astra 的“高考”成绩单(上):先看懂这七门考试 先看题,再看分数。拆开七项评测的任务、计分方式与人类参照,理解 Astra 成绩单的分量。
作者:Liqing Pan 2026年9月8日 约 19 分钟阅读
图片来源: Prompthon editorial artwork. “欢迎来到 AGI 时代。”
2026 年 9 月 3 日,GPT-6 Astra 发布。OpenAI 总裁 Greg Brockman 在面向记者的电话会上,把话说到了这个份上。(发布报道,见参考资料 [1])
底气在哪里?打开发布页,数学、编程、专业工作……一张张评测图排下来,颇有点高考放榜的架势。(官网说明,见参考资料 [2])
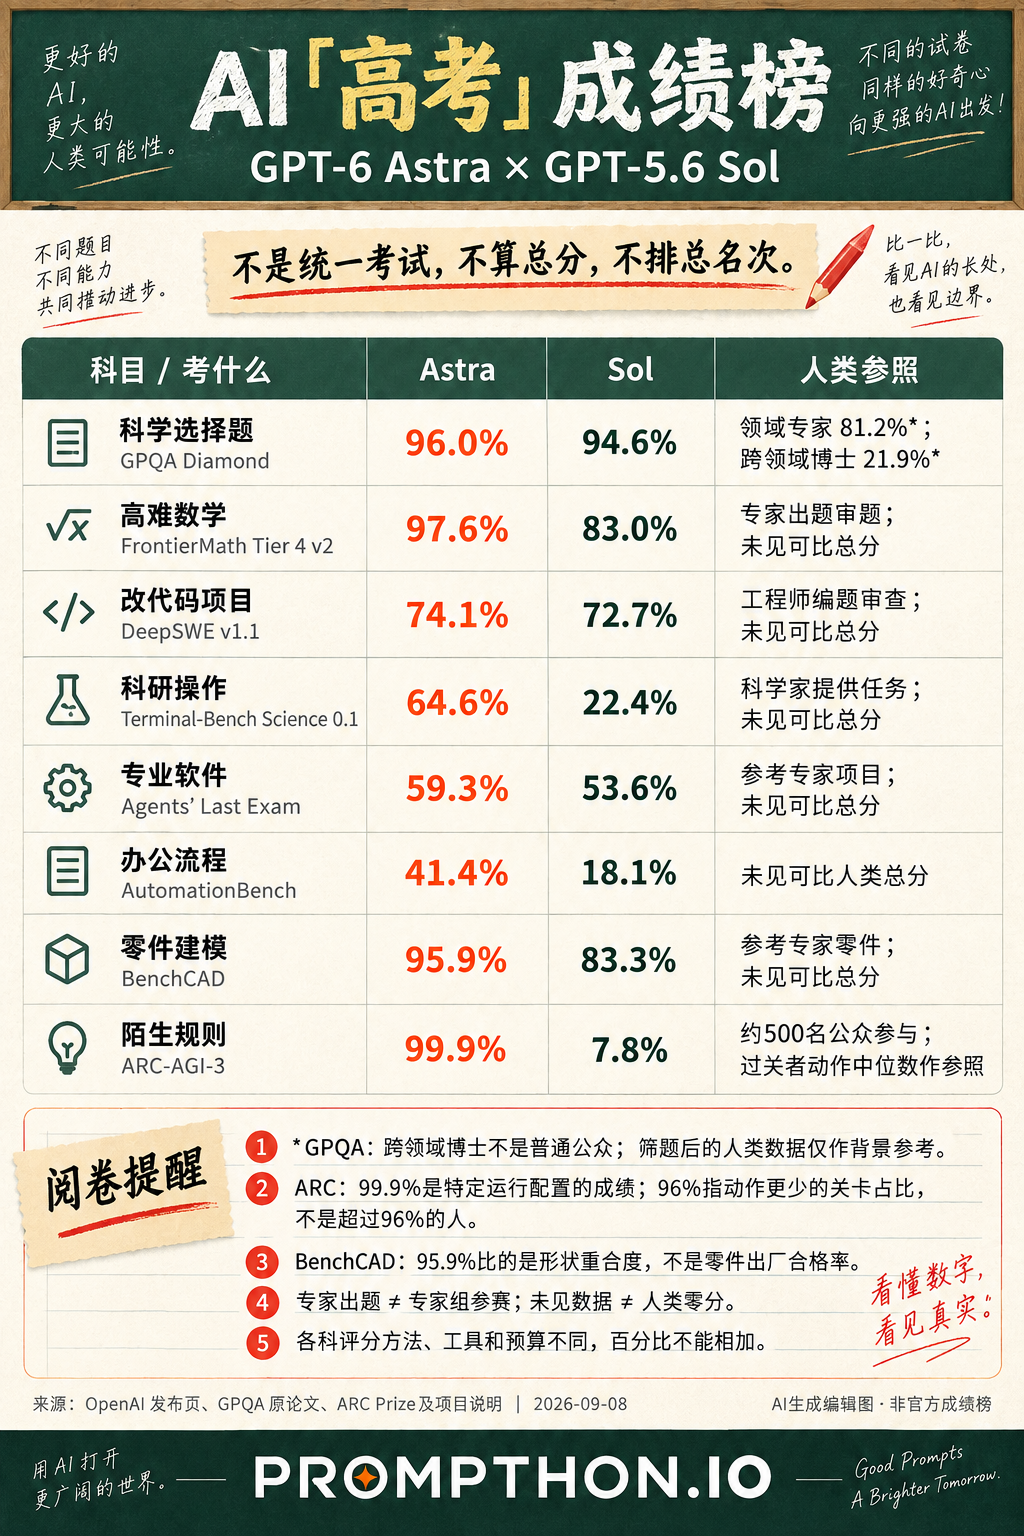
其中最抢眼的是 ARC-AGI-3:让 AI 自己摸索陌生环境的规则,Astra 拿到了 99.9% 。发布页还说,它在 96% 的关卡 里,完成任务用的动作比人类参照更少。(组织者报告,见参考资料 [3])
成绩这么漂亮,难道 AGI 真到了?
先别急。我们看高考成绩,也得先知道考了哪些科目。AI 的这些“考卷”是谁出的,题目有多难,又是怎么打分的?把这些弄明白,高分到底有多大分量,心里才有数。
先看懂 AI 的“高考”,再判断 AGI
借这次 Astra 发布,我们分上下两篇拆开八项评测。本篇先看七门考试;最抢眼的 ARC-AGI-3,留到下篇细讲。读完以后,你再看到“接近满分”“超过人类”,就能自己判断:它到底厉害在哪,又有哪些事还没考到。
先看题,再看分数。下面的样题有的是公开原题的概述,有的是论文中的任务示例;版本和用途都在旁边注明。
1. GPQA Diamond:允许上网查,也未必答得出来
2023 年 11 月,David Rein 和同事们拿出了一套有点“较真”的科学选择题:生物、物理、化学,四个选项,选一个。听着像学生时代做过的卷子,但他们想堵住一条捷径——不会没关系,上网搜一下,总能找到答案吧?
为此,团队找来本专业的专家,也找来学历和能力不错、但不研究这个领域的人答题。后者可以随便上网查,平均一道题花了半个多小时,最后也只答对约三分之一。这就是名字里“Google-proof”的意思:不是不让你搜,而是搜了也没那么容易会。(原始论文,见参考资料 [5])
题型示意|不是 GPQA 原题
在温度、酸碱度不变的条件下,一种抑制剂只与底物争抢酶的同一个结合位置。不断增加底物,最可能怎样?A. 最大反应速度必然降低;B. 底物足够多时,仍可接近原来的最大反应速度;C. 酶会被永久破坏;D. 反应从此完全停止。
这道自拟小题的答案是 B,只用来示意“根据条件判断,四选一”,不代表 GPQA 的真实难度。关键不是记住一个生物学名词,而是看懂“只争抢同一个位置”这个条件:底物足够多,就有机会把竞争的影响抵消。GPQA 把这种判断放进更深的专业问题里。作者为减少题目进入训练资料,明确请求不要在网上重贴原题,因此这里没有搬运题库。(论文与使用提醒,见参考资料 [4])
先看看人来答会怎样。GPQA 原论文的表 5 给 Diamond 子集列了两组参考成绩:本领域专家 81.2% ,非本领域答题者 21.9% 。但后者不是街头随机找来的普通人,而是其他领域的博士或博士生。还有个关键细节:这批题本来就按“专家较能答对、外行较难答对”筛过,不能把这两个数字当成一场全新、同条件的人机比赛;两位专家分别审核,也不等于专家组一起作答的成绩。(原始论文,见参考资料 [4])
图片来源: OpenAI — GPT-6 Astra release; official evaluation chart.
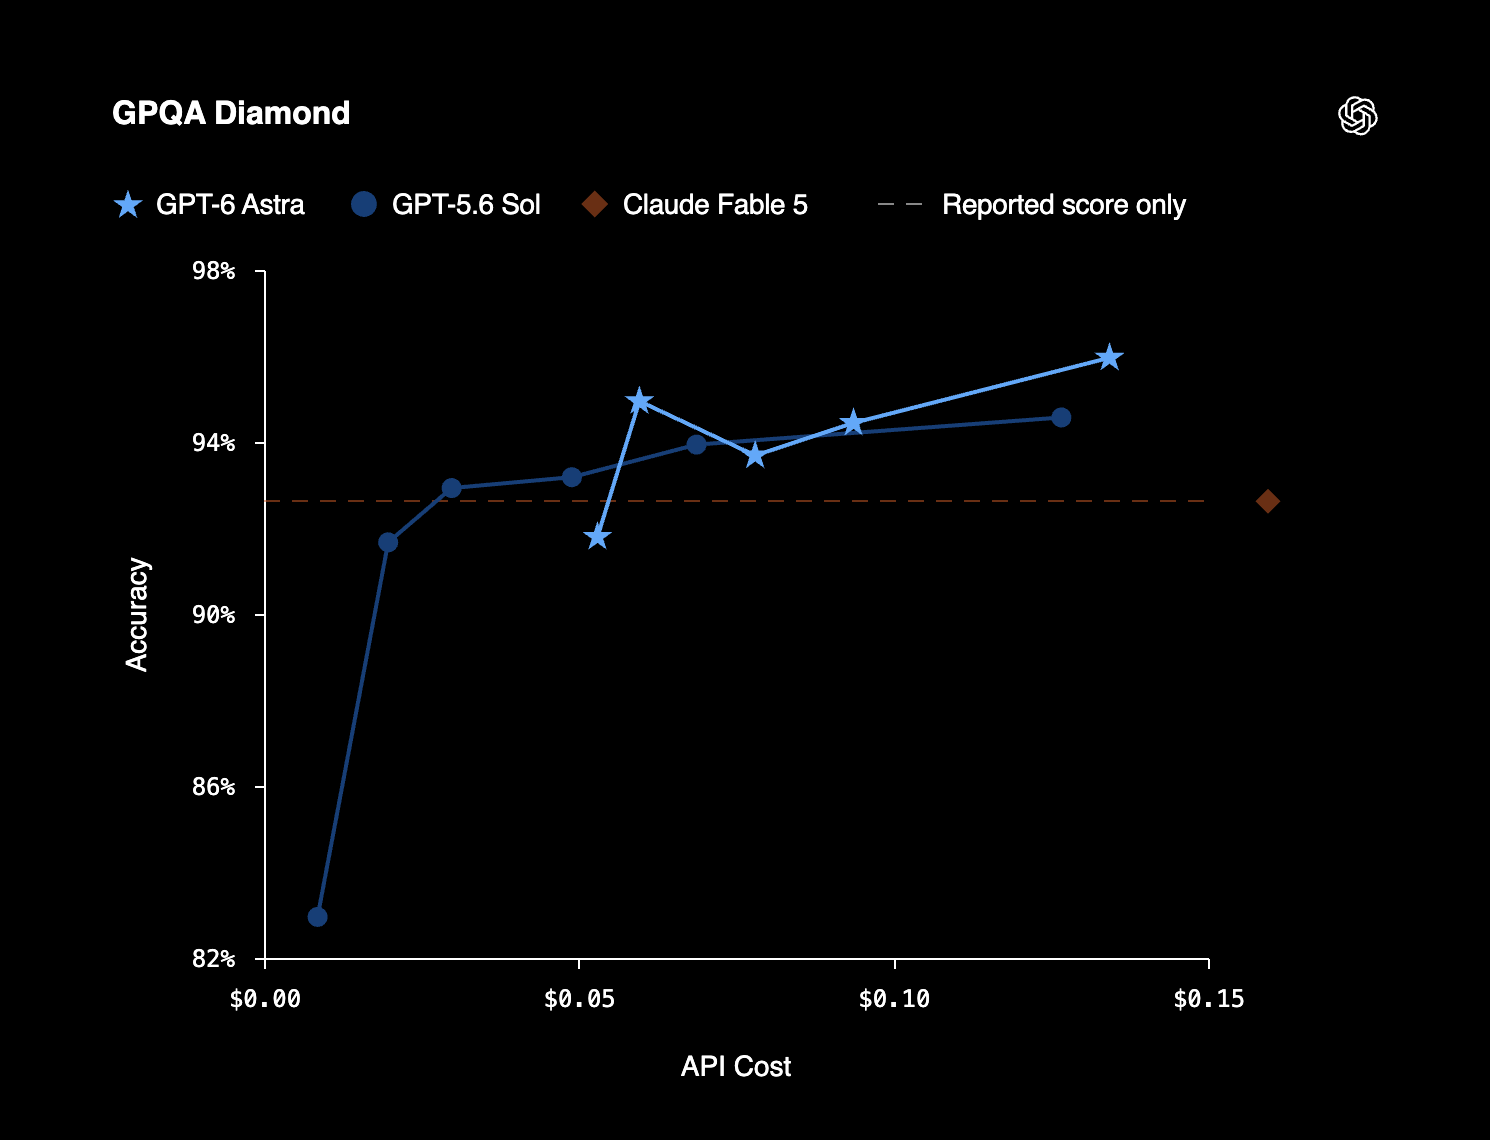
图:OpenAI 发布页原图。GPQA Diamond:Astra 96.0%,Sol 94.6%。同一模型的多个点及花费读法,见第 5 节说明。可点开看大图。
今天榜单里常见的 Diamond,是从题集中进一步筛出的 198 道题。Astra 答对了 96.0% ,上一代 GPT-5.6 Sol 是 94.6% 。两代都已经很高,Astra 又往前走了一点。前面那个约三分之一,是当年另一组人的原始题集结果,不能直接和今天的 Diamond 成绩排在一起当人机比赛。
题答对了,当然厉害。但真把实验器材摆到它面前,它能不能把实验做成?这套题没考,光看这个分数还不知道。
2. FrontierMath:数学家认真出难题,AI 能撑多久? 到了 2024 年,另一群人也遇到了类似的麻烦:AI 在旧数学题上越来越会拿高分,再拿这些题考它,到底还能看出多少东西?
研究机构 Epoch AI 的做法是,请数学家重新出题。2024 年 11 月,Elliot Glazer 等人发表 FrontierMath 论文,题目要求原创、没公开过,而且真要难——有些题,连研究这个方向的人也得算上好几个小时,难的甚至要花几天。(原始论文,见参考资料 [7])
这个项目还有个挺有意思的细节:Epoch 在年度回顾中说,他们请了三位菲尔兹奖得主和一位国际数学奥林匹克竞赛专家评价难度。换句话说,不是出题人自己拍胸脯说“我这题难”,还找了顶尖行家来看看。(项目回顾,见参考资料 [8])
考法倒不故弄玄虚。模型可以借助电脑计算、反复尝试,最后必须交出能核对的答案。写得再长、语气再自信,答案不对也没分。
公开样题|2024 年论文附录 A.5,非 Tier 4 v2
在一个含有 5¹⁸ 个元素的有限域中,方程 x³y+y³z+z³x=0 有多少个非零解?把整体乘以同一个非零数后得到的解,算成同一个。(原题中文转述,见参考资料 [17])
先别被“有限域”三个字劝退:这里不是让 x、y、z 随便取普通实数,而是在一套元素有限、运算规则确定的数系里数答案。难处是可能性太多,还得把只是整体放大或缩小的重复答案归到一起,不能叫电脑挨个试就完事。更有意思的是,这在早期论文里还被归为相对容易的一档。它让我们看题型,不是说 Astra 的 Tier 4 v2 分数就是在这道旧样题上测出来的。
这套题的人类参照,主要来自数学家:有人负责出题,有人核对答案,还有顶尖同行评价难度。“专家也要算几小时甚至几天”能帮助我们体会它有多难,但不是专家在统一限时下考出的总分。本次核对的题集说明没有给出能与这张模型成绩表直接并排的普通人、专家或专家组成绩,所以这些栏位暂不填数字。(题集说明,见参考资料 [6])
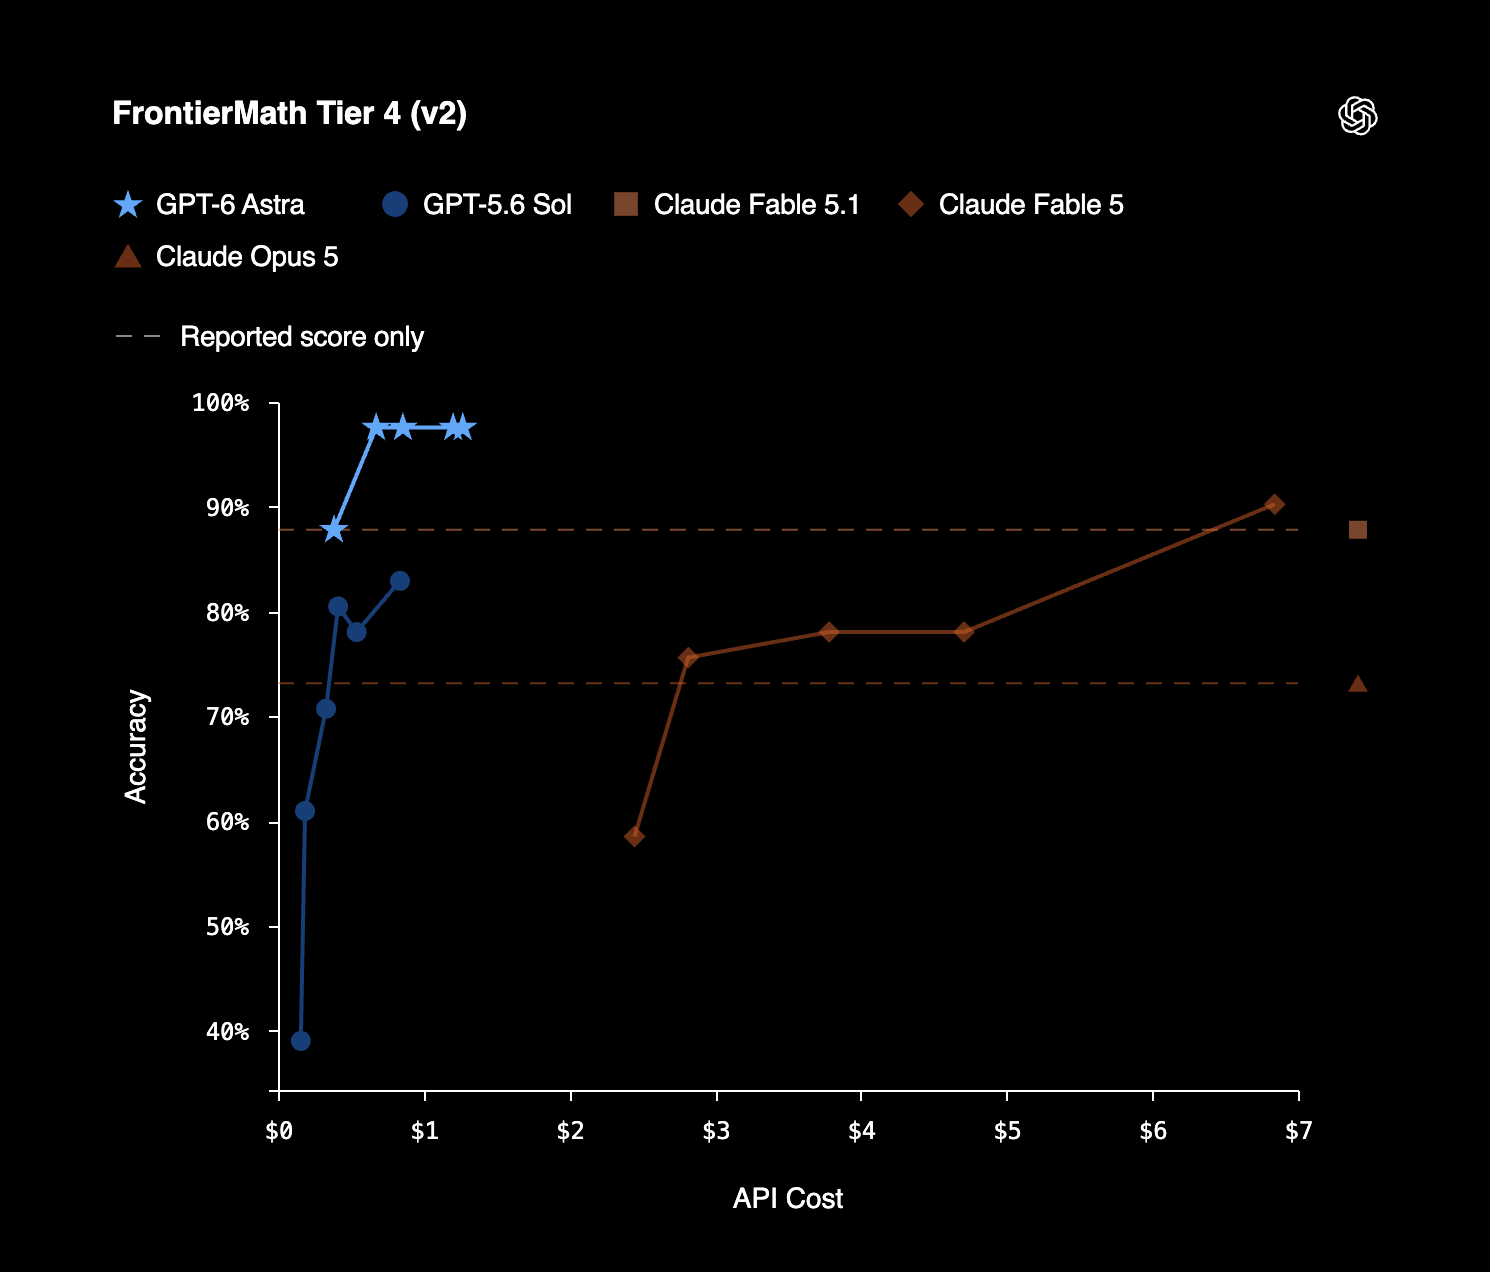
图片来源: OpenAI — GPT-6 Astra release; official evaluation chart. 图:OpenAI 发布页原图。FrontierMath Tier 4 (v2):Astra 97.6%,Sol 83.0%。同一模型的多个点及花费读法,见第 5 节说明。可点开看大图。
这次 Astra 在最难一档 Tier 4 v2 上拿到 97.6% ,Sol 是 83.0% 。当初专门为了难住 AI 而出的题,如今又快被做到头了,确实值得吃惊。
不过,题目本身也在变。Epoch 在 2026 年 6 月修正过一批题,所以这里要认准 v2,不能拿不同卷子的分数硬比。(题集说明,见参考资料 [6])
更别把它读成“人类没解决的数学难题,Astra 已经解决了 97.6%”。这里考的,是出题人有办法核对答案的一套难题;数学世界里还有多少问题没解开,不归这个百分比管。
3. DeepSWE:你是真的会修,还是见过答案? AI 写代码的成绩越来越好,有人开始追问:它是不是早就看过这道题的答案?
这不是凭空挑刺。很多编程评测会从网上的开源项目里找已经修好的问题:问题描述公开,大家怎么讨论公开,最后怎么修也公开。模型训练时要是看过,拿高分就可能不全靠现场本事。
2026 年 7 月,Wenqi Huang 等人发表 DeepSWE,专门冲着这个麻烦来。他们在真实项目上重新设计了 113 道工程任务,并另外编写检查程序:只要你确实把要求的功能做出来,就不必和参考答案写得一模一样。(论文,见参考资料 [10])
公开样题|Happy DOM 的“收尾工作”
给模拟浏览器环境的 Happy DOM 修一个问题:页面关闭或跳转时,尚未读完的请求、响应要正确中止;已经读好的内容仍能使用,不该继续运行的定时任务要清掉。(论文附录 E 任务的中文概述,见参考资料 [9])
用起来只是点一下关闭,软件里面却可能还有好几件事没干完。难的是分清哪些该停、哪些不能误伤,再去真实代码里找到负责这些行为的地方。把所有东西一刀切停掉,可能修好了旧毛病,又造出新问题。题目也不会告诉 AI“去第几个文件改第几行”;它得自己查、自己改,再证明正常功能没被弄坏。
这里的工程师首先是出题人和检查者:他们写出可行的参考修改,再确认 AI 交上来的代码是否真的满足要求。参考答案有人做出来,不等于找来一批程序员、给同样时间后人人都能做出来。论文没有提供可与本表并列的人类总分,也明确没有估算人类做题需要的实际时间。我们能比较两代 AI,暂时不能据此说它超过了多少程序员。(论文,见参考资料 [9])
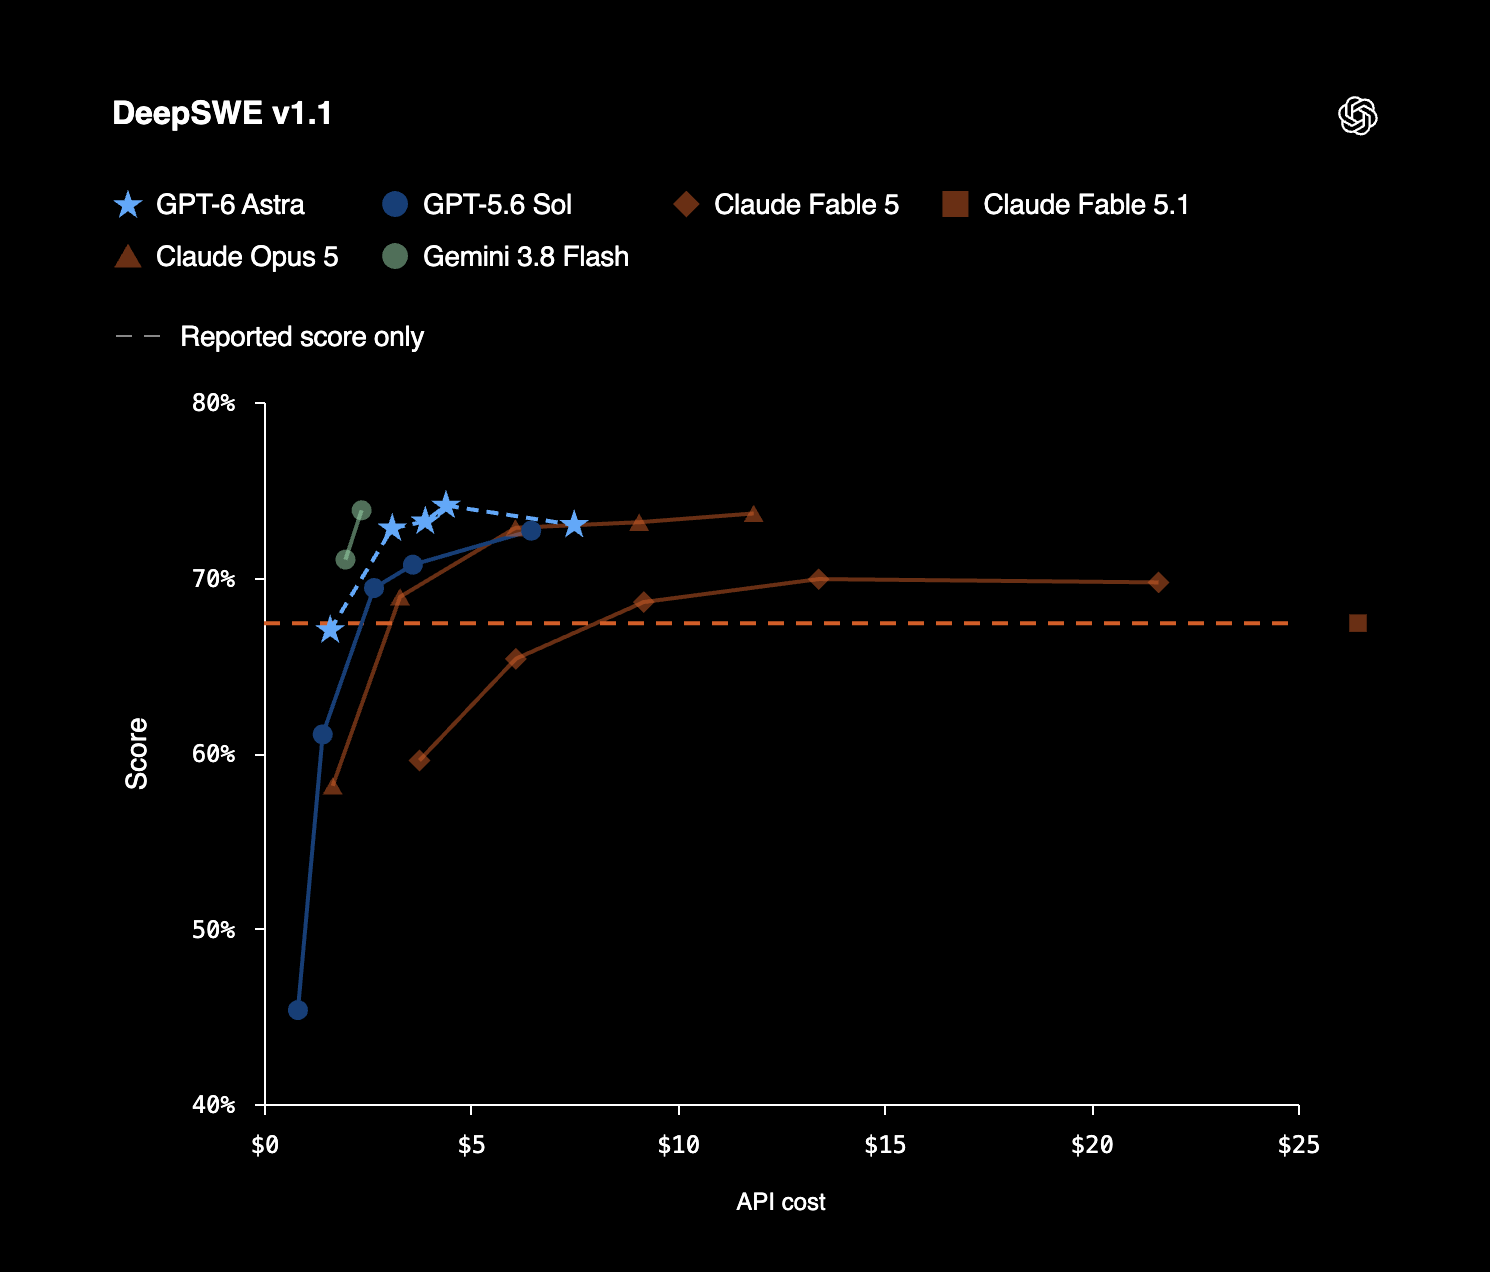
图片来源: OpenAI — GPT-6 Astra release; official evaluation chart. 图:OpenAI 发布页原图。DeepSWE v1.1:Astra 74.1%,Sol 72.7%。同一模型的多个点及花费读法,见第 5 节说明。可点开看大图。
Astra 在 DeepSWE v1.1 上的成绩是 74.1% ,Sol 是 72.7% 。这一项的进步就没有前面的数学题那么抢眼。
它更接近我们真正关心的“能不能把项目改好”,但也不是给 AI 颁了一张万能程序员证书。换个项目、换个要求,仍得看它实际交上来的东西。
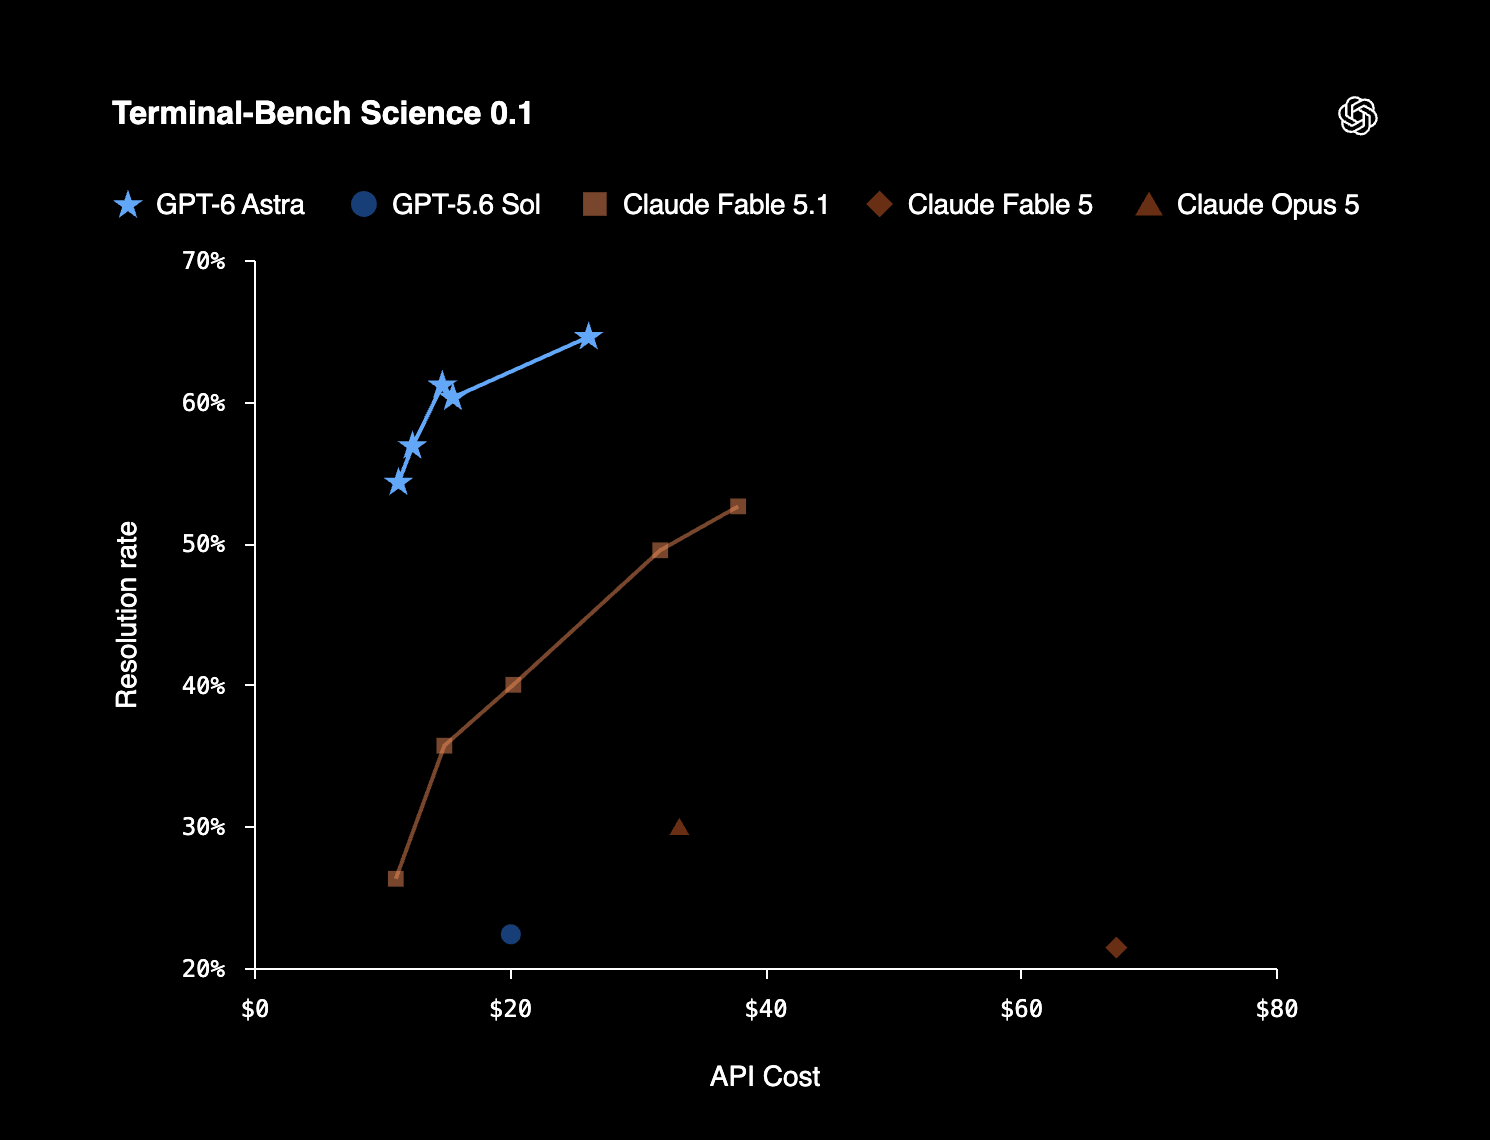
4. Terminal-Bench Science:科学家把手头的麻烦拿来出题 如果你是一名研究者,AI 把一个科学名词解释得再漂亮,也不一定能帮你提前下班。数据还没处理,模拟还没跑完,程序又报错了——这些活儿总得有人做。
Terminal-Bench Science 就把目光放在这里。它由斯坦福的研究者牵头,和 Terminal-Bench 团队、不同领域的科学家一起建设,题目从研究者自己的工作里来。
最有意思的是选题过程:首版收到 920 个提案,最后只有 70 道任务入选 。不是“难”就够了,还得确实是科研工作中值得做的事,而且做没做好,能检查清楚。(首发报告,见参考资料 [11])
公开任务示例|换一张网格,数据不能凭空变多
修复用于大气与海洋模型衔接的网格转换程序:把球面上一套网格的数据转到另一套网格,既要正确处理被遮掉的区域,也不能破坏题目要求保持的总量和取值范围。(公开仓库 masked-spherical-remap 任务的中文概述,见参考资料 [18])
你可以把它理解为:同一片海域,两个研究程序把它切成了大小、形状不同的小块,现在要把数据接过去。不能只让新图看起来平滑,还得保证转换没有凭空添出或漏掉东西。球面、缺失区域和边界一掺进来,简单取平均就容易出问题;AI 最后要交出真能通过检查的程序。这个例子取自当前公开仓库,用来展示工作方式,不据此认定它就是 0.1 版计分题。
如果找科学家来做呢?这些任务本身就取自研究者的工作,科学家还参与出题和检查,说明要求并不是凭空想出来的。不过,首发报告没有给普通人或科学家安排一场可与模型直接比较的统一考试。有人能完成某个科研任务,不等于每位科学家都能把全部跨领域任务做完。(首发报告,见参考资料 [11])
图片来源: OpenAI — GPT-6 Astra release; official evaluation chart. 图:OpenAI 发布页原图。Terminal-Bench Science 0.1:Astra 64.6%,Sol 22.4%。同一模型的多个点及花费读法,见第 5 节说明。可点开看大图。
OpenAI 这次公布的成绩,Astra 是 64.6% ,Sol 是 22.4% 。这是一处很明显的提升:不是更会讲科学了,而是在这些指定的科研活儿上,做成的更多了。
数字来自 OpenAI 的这次测试,不能说成我们或项目组织者重新跑了一遍、得到了相同结果。至于它能不能独立当科学家,先别急——把别人布置的研究任务做完,和自己发现一个值得研究的新问题,还隔着不少事情。
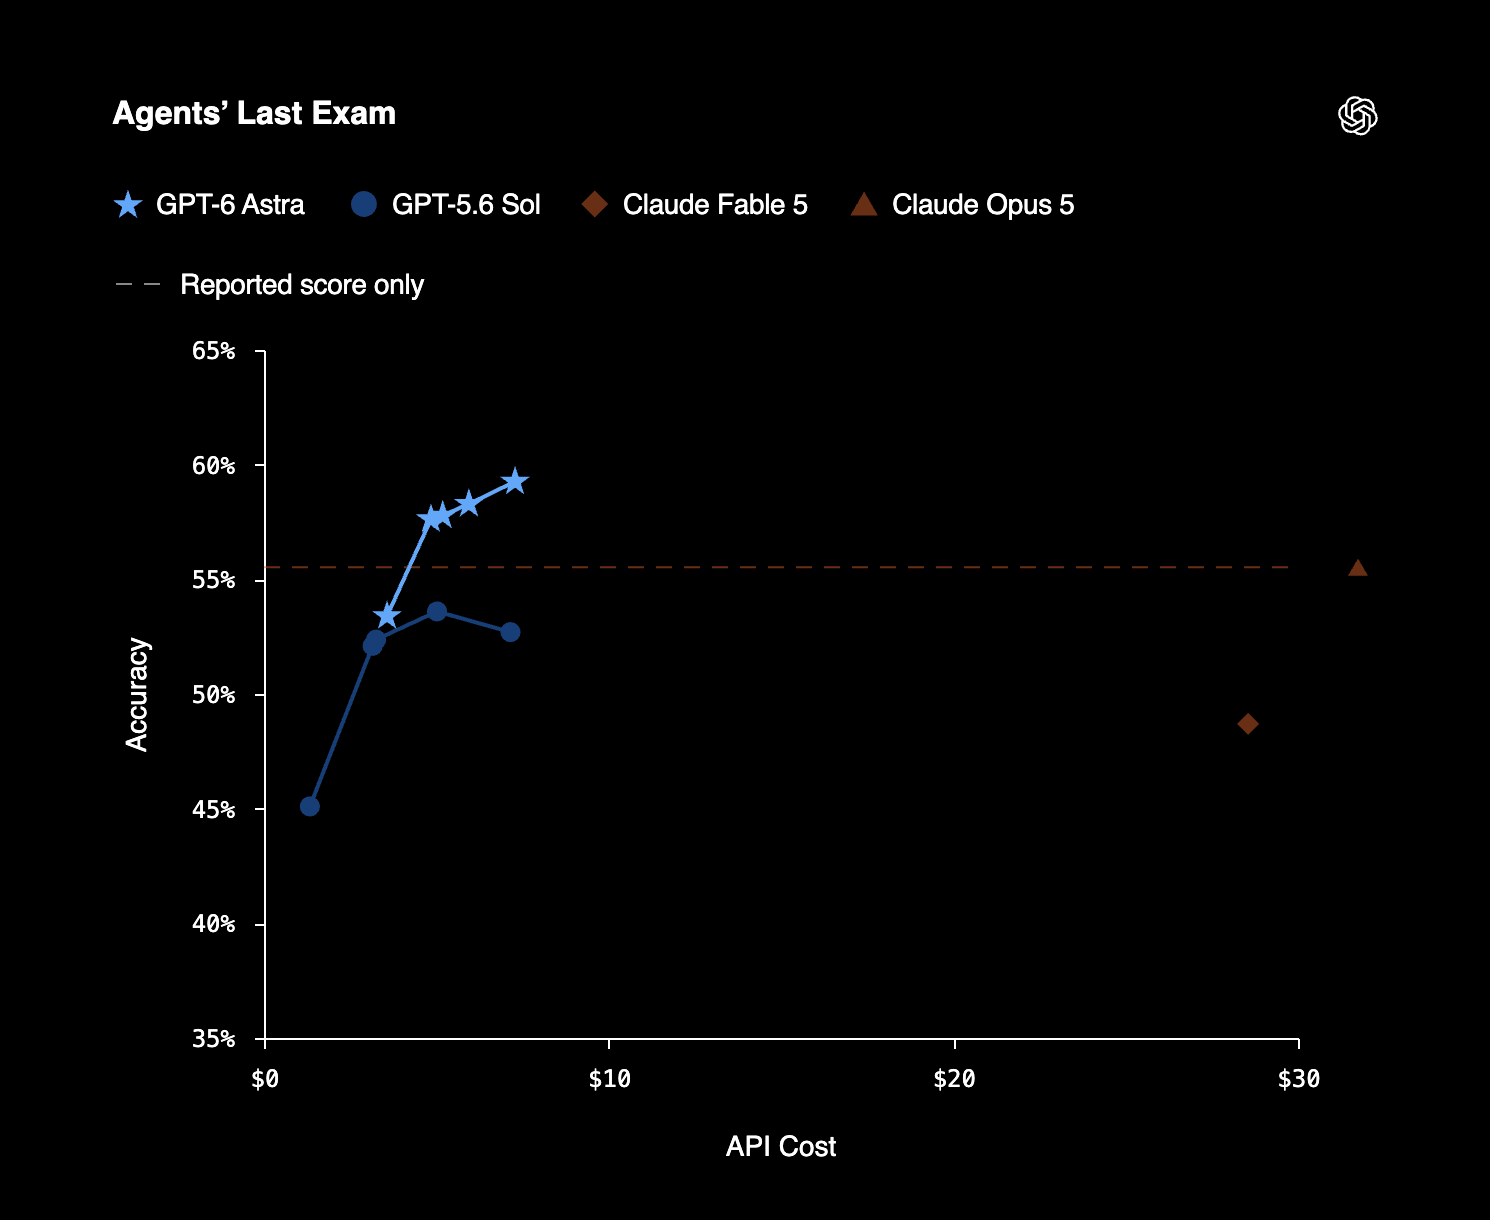
5. Agents’ Last Exam:别光告诉我怎么做,软件已经打开了 2026 年 6 月,Yiyou Sun 等人发表 Agents’ Last Exam。项目由加州大学伯克利分校 RDI 和 RDI Foundation 牵头,关心的不是模型能把知识讲得多好,而是让它进入真实软件之后,能不能完成专业工作。(论文,见参考资料 [13];项目介绍,见参考资料 [14])
论文中的任务示例|把奔跑的猎豹放进另一段视频
不是给视频随手加一个滤镜,而是把一段素材里奔跑的猎豹,合成到另一段竞赛视频里。(论文用来说明合格任务规模的示例,见参考资料 [12])
难点不在截一张猎豹的图贴上去。它会跑,身体姿势会变,镜头也会动;得把它从原背景里分出来,让它在新画面里连贯地运动,颜色也不能一眼穿帮。论文用这个例子说明,想考的是几项工作接起来的一整套流程,不是点一个按钮。这里展示的是论文的任务设计示例,不声称它对应发布页的某一次计分运行。
这项与专家的联系更直接:论文说,任务来自专业人士已经做过的项目,模型的产物要对照专家提供的参考结果来检查。专家委员会也参与审核。但这不是“AI 对战专家组”:委员会在检查题目,不是组队参加比赛。本次核对的资料没有列出可与 Astra、Sol 同栏排序的普通人、专家或专家组总分。(论文,见参考资料 [12])
图片来源: OpenAI — GPT-6 Astra release; official evaluation chart. 图:OpenAI 发布页原图。Agents’ Last Exam:Astra 59.3%,Sol 53.6%。同一模型的多个点及花费读法,见第 5 节说明。可点开看大图。
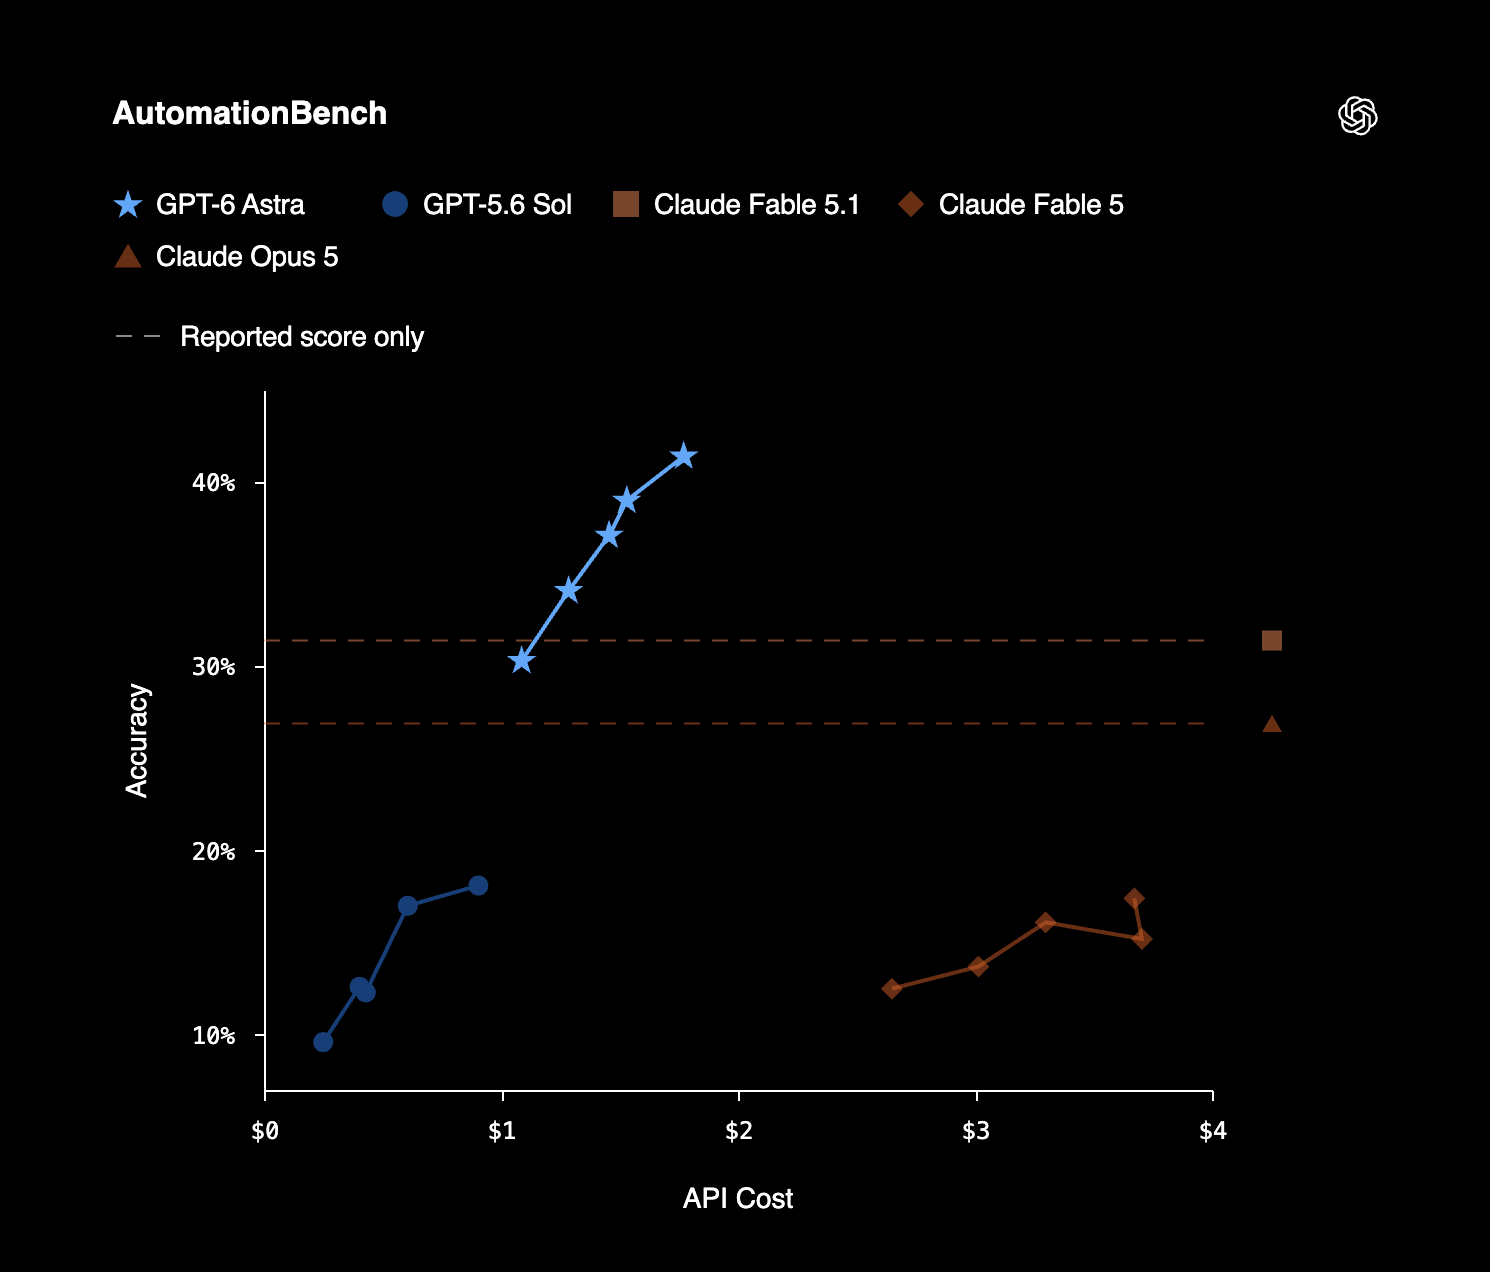
这些图上的点怎么读?横轴是 API 花费,纵轴是得分。同一个模型有多个点,可以结合官网的推理强度说明来理解:给它不同程度的思考投入,花费和成绩也会变化;不是每个点都代表一个新模型。官网明确说,汇总表取的是不同推理强度下的最高分。(官网说明,见参考资料 [2])
为什么 Claude Fable 5 和 Opus 5 这里只有一个点?这张图只展示了它们各一个结果;官网正文没有交代为何不画更多设置,不能据此认为它们只有一档。读这张图,要把“得了多少分”和“花了多少钱”一起看。
ALE 会检查模型留下的文件和结果,不会因为它说了一句“已完成”就给分。Astra 这次是 59.3% ,Sol 是 53.6% 。
这个分数没有“59.3% 的职业可以交给它”那么大的意思。它只告诉我们,在这批专业任务的评分里,Astra 比上一代做得更好了。真到你自己的工作,还得看看它交出的文件是不是能用。
6. AutomationBench:邮件写对了,发错人也不行 比起高深的科学题,办公室里有些活看上去实在没什么技术含量:改一下客户资料,建个日程,再通知相关同事。
但做过的人都知道,这类事最烦的就是“差一点”。金额对了,客户错了;邮件写得很好,收件人不对。每一步看着都像做了,合在一起却不能交差。
Zapier 的 AutomationBench 就拿这些业务流程来考 AI。它搭出模拟的客户系统、邮箱、日历等工具,让模型在里面办事,最后再检查:该改的记录是不是改了,该通知的人是不是收到了通知。(项目说明,见参考资料 [15])
它有个很能说明问题的规定:一项任务要求检查的地方,必须全部过关,才算完整做成。
公开样题|两场会撞车了,听谁的?
Zoom 和 Google Calendar 里有两场会时间重叠。请先查表格里的会议优先级规则,给需改期的那场会加上 [RESCHEDULED] 标记,再到指定 Slack 频道说明处理结果,并带上两场会的编号。(论文简化公开样例的中文概述,见参考资料 [19])
看起来像改个日程,坑却藏在“到底改哪一场”里:有个外部合作方发邮件说自己的会更重要,但题目里的公司规则不允许它覆盖内部优先级;还有别的会议名称相近,时间却不一样。AI 得找到对的记录、按对的规则处理,最后通知对的频道。样题里的“改期”以加标题标记验收,并不是要求它另外找一个新时段;我们也不能擅自把考题加码。
这类工作听起来最像普通上班族的日常,但不能因此替人类填一个满分。项目说明公布了模拟业务环境和完成标准,本次没有查到普通人、熟练职员或专家组在同一套正式题集上的可比总分。因此,我们能说 AI 办成了多少任务,还不能说它已经超过了多少上班族。(项目说明,见参考资料 [15])
图片来源: OpenAI — GPT-6 Astra release; official evaluation chart. 图:OpenAI 发布页原图。AutomationBench:Astra 41.4%,Sol 18.1%。同一模型的多个点及花费读法,见第 5 节说明。可点开看大图。
Astra 的完整任务通过率是 41.4% ,Sol 是 18.1% 。比上一代进步很大,但还是有不少任务没能全部做对。
这里看的是官方采用的较难私有题集,不是网上公开练习题的榜单。对我们来说,更值得留意的不是它说得多像一个靠谱同事,而是最后有没有把事情办妥。
7. BenchCAD:画得挺像,螺丝却拧不进去 AI 生成一张漂亮图片,已经不太稀奇。可如果让它画的是一个真的要装到机器上的零件,事情马上就不一样了:孔偏一点,厚度差一点,都可能装不上。
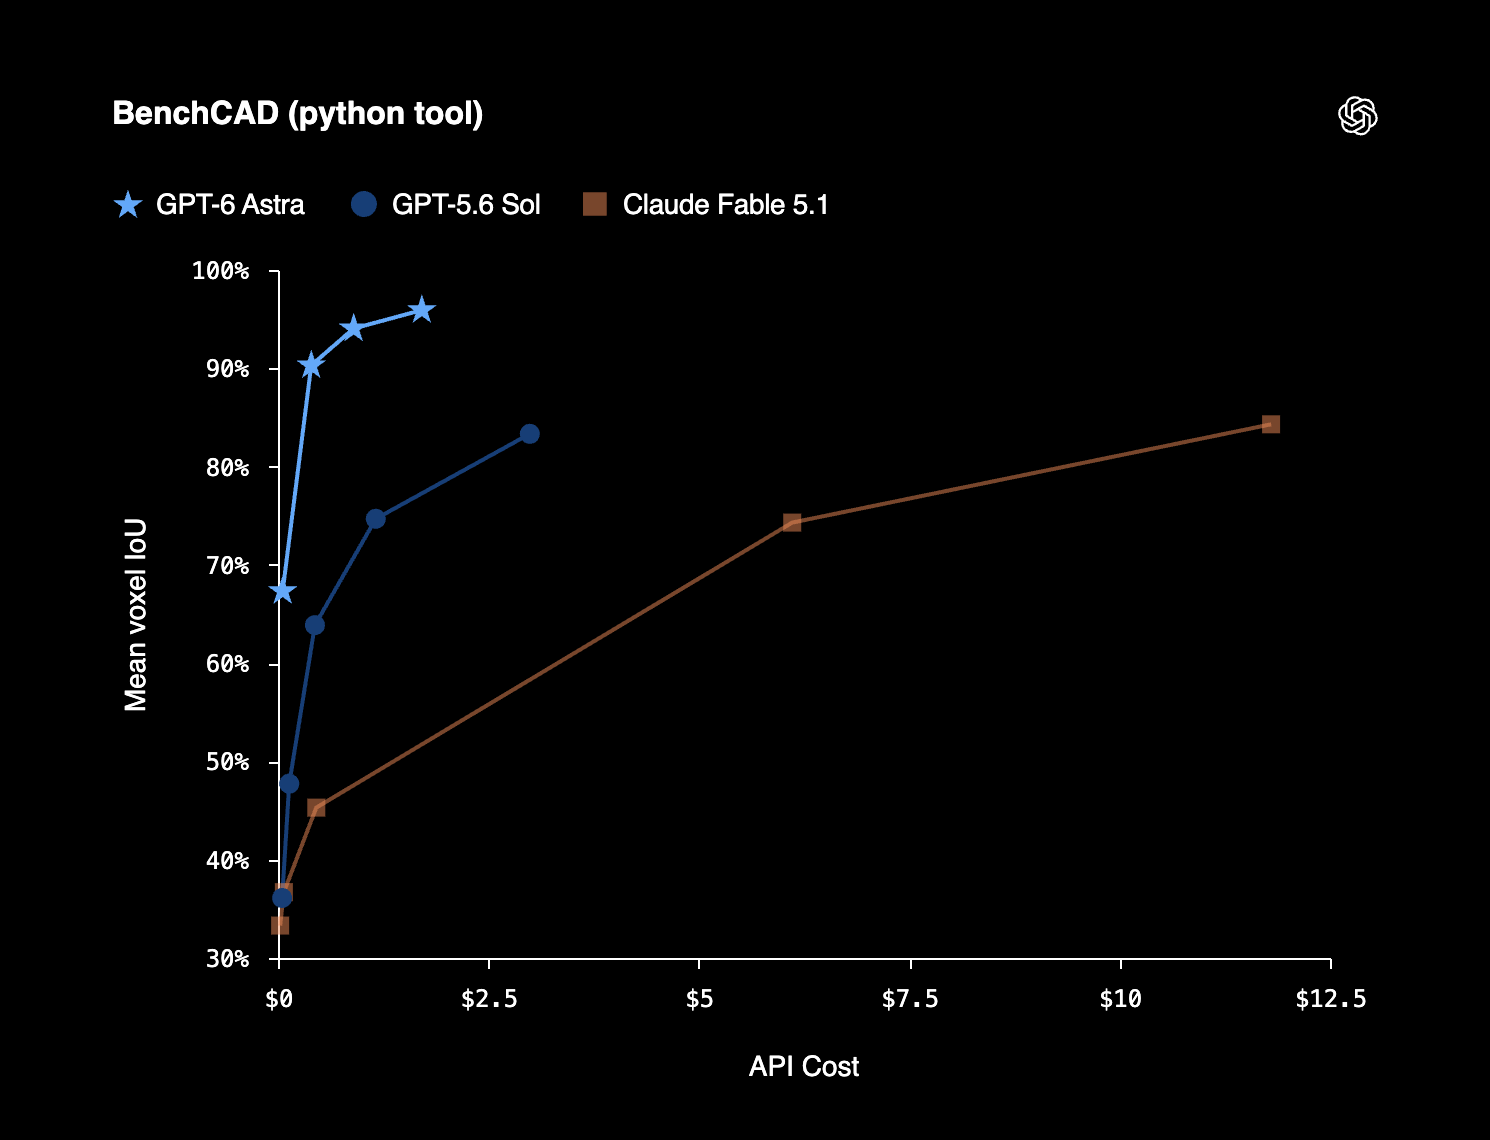
BenchCAD 在 2026 年 6 月 2 日的介绍文章里,就把这个问题挑了出来。项目团队让模型看机械零件的不同视图,再写代码,把三维零件还原出来。它要的不是“看着挺像”,而是形状和尺寸确实对得上。(项目介绍,见参考资料 [16])
为此,团队准备了不同工业零件的材料,其中不少来自实际标准。这样就不只是考 AI 会不会画一个好看的东西,还要看它能不能看懂:这里有几个孔,那里有多厚,从另一面看又是什么形状。
公开案例|孔看着有了,里面却没打通
修改一个电机端盖,在中央打出半径 20 毫米的圆柱形通孔,贯穿下方的盘状部分和上方凸起。(BenchCAD-Edit 案例 167 的中文概述;它展示空间错误,不是发布页形状重建分数的同一道计分题。见参考资料 [20])
这个案例很直观:程序先在底下打了孔,随后又把上方的实体加回来,结果从某个角度看着像有孔,中间却仍堵着。论文展示的几种错误结果,整体形状已经很接近参考件,但关键的一孔没有贯通。难的不是把“打孔”两个字翻译成代码,而是想清楚操作顺序最终留下了什么三维形状。
这里拿来对照的,是专家构建的参考零件,而不是某一组人现场建模的平均成绩。项目介绍没有公布可与本表直接并排的人类总分。就算把标准零件自身的重合度看成满分,也不能把这个满分写成“人类专家得分”——那是标准答案,不是人参加考试的结果。(项目介绍,见参考资料 [16])
图片来源: OpenAI — GPT-6 Astra release; official evaluation chart. 图:OpenAI 发布页原图。BenchCAD (python tool):Astra 95.9%,Sol 83.3%。这里比的是形状重合度,不是可出厂零件比例。可点开看大图。
Astra 的成绩是 95.9% ,Sol 是 83.3% 。这个分数说的是生成形状与参考形状有多接近,不是“做出来的零件有 95.9% 可以直接出厂”。
形状做对了,是很重要的一步。至于材料够不够结实、机器能不能加工出来,还得接着检查,不能只看这一个分数。
把这几门考试,放回一张成绩榜 图片来源: Prompthon editorial overview, based on cited evaluation sources. 图:八项评测与人类参照一览,非官方榜单。各项百分比不能相加;人类栏是不同研究的参考,不是统一参赛排名。ARC 的 99.9% 与 96% 人类对比采用不同推理设置,下篇详解。
七门看完,最抢眼的那一门还在后面 一科科看下来,Astra 的进步有了具体的样子:不只是会答题,还要改好软件、处理研究数据、完成专业工作。但各科也有各科的短板,不能挑几个最高分,就替它宣布“什么都会了”。
如果前面这些考试让我们看见它能做成什么,那么 ARC-AGI-3 想追问的是:不给说明书,面对没见过的东西,它能不能自己学会?
下篇,我们把这项压轴评测单独拿出来:先看两段真实的解谜案例,再看它究竟怎样超过人类参照,以及为什么同一个模型,换一套运行程序,成绩会差这么多。
下篇预告|99.9%,离 AGI 还有多远?
系列下篇:《GPT-6 Astra 的“高考”成绩单(下):99.9%,离 AGI 还有多远?》
在 Prompthon 继续追这张成绩单。我们一起看看,那句“AGI 已经到了”,到底有多大分量。
本文依照原始资料重新组织,所列数字对应特定版本与配置,并非持续更新的实时排行榜;样题与官方演示不等于本文实测。核对日期:2026 年 9 月 8 日。